
10 - Grafos e Machine Learning: Attention é um grafo: a matemática que une Transformers e redes
No artigo anterior, o GAT (Graph Attention Network) apareceu como a arquitetura que não trata todos os vizinhos igualmente, aprendendo um peso diferente para cada conexão. Deixei uma promessa em aberto ali: esse mecanismo de atenção é, estruturalmente, o mesmo usado em Transformers, a arquitetura por trás dos modelos de linguagem mais usados hoje.
Esse é o fechamento desta série. Não é uma analogia solta, é uma equivalência matemática direta, e vamos construí-la do zero.
O que "attention" significa, sem jargão
Em todos os artigos anteriores desta série, a estrutura da rede vinha pronta, "Carla" fala com "Ana", "Ana" fala com "Bruno", um link existe ou não existe, fixado de antemão pela própria definição do problema. O message passing do Artigo 9 herdava essa estrutura fixa, cada nó só trocava mensagem com quem já era seu vizinho direto.
Attention rompe essa premissa. Em vez de uma estrutura fixa, cada elemento (uma palavra, uma pessoa, um nó) calcula, ele mesmo, o quanto cada outro elemento importa para ele, e essa importância vira o peso de uma conexão. Não existe mais "vizinho" fixo, existe um grau de relevância, calculado, entre cada par.
Formalizando: Query, Key, Value
O mecanismo de atenção (explicado neste artigo), transforma cada elemento em três vetores diferentes, através de três transformações treináveis:
Q (query, "pergunta"), o que este elemento está procurando. K (key, "chave"), o que este elemento tem para oferecer. V (value, "valor"), a informação que este elemento carrega, se for escolhido.
A compatibilidade entre um elemento i e um elemento j é o produto interno entre a pergunta de i e a chave de j, normalizado pela dimensão d dos vetores:

Esses scores passam por um softmax, transformando-os em pesos que somam 1, e a nova representação de i é a soma ponderada dos valores V de todo mundo, usando esses pesos:
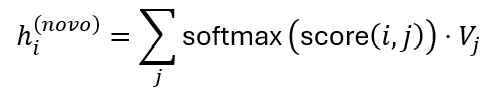
Attention é, literalmente, um grafo
Aqui está o ponto central deste artigo. Olhe de novo para a fórmula acima, e compare com o message passing do Artigo 9.

As duas fórmulas fazem a mesma coisa, uma soma ponderada das representações dos vizinhos. A diferença inteira está em duas perguntas, quem conta como vizinho, e qual o peso de cada um.
No message passing clássico (GCN), o "quem conta como vizinho" vem da matriz de adjacência A, fixa, definida pela estrutura real da rede, e o peso de cada vizinho é fixo também (geralmente uniforme, ou baseado só no grau).
Em attention, todo elemento é vizinho de todo elemento, o grafo subjacente é completo (denso, ligando todo mundo a todo mundo), e o peso de cada conexão não é fixo, é calculado, dinamicamente, pela compatibilidade entre query e key. Attention não abandona a estrutura de grafo que construímos ao longo de toda esta série, ela generaliza essa estrutura, trocando uma matriz de adjacência fixa, com 0 ou 1, por uma matriz de adjacência aprendida, com pesos contínuos, recalculados a cada nova entrada.
Um Transformer processando uma frase é, matematicamente, uma GNN rodando sobre um grafo completo, onde os pesos das arestas (a "matriz de adjacência") não são dados de antemão, são a própria saída do mecanismo de atenção.
Um exemplo pequeno
Reaproveitando "Carla", "Ana", "Bruno" e "Diego", vamos ver o mecanismo de attention funcionando com números reais.
O que são esses vetores, antes de qualquer conta
No Artigo 6, vimos embeddings no sentido que Node2Vec usa, um vetor de números aprendido a partir da posição estrutural de cada nó na rede, via passeios aleatórios. Aqui, o sentido é mais simples, e mais genérico, cada pessoa vira um vetor de duas posições, só para poder capturar mais de uma característica ao mesmo tempo (nos artigos sobre o Laplaciano e message passing, cada pessoa carregava um único número, a opinião sobre um assunto, o que bastava ali, mas não é suficiente para o tipo de comparação que attention faz). Neste exemplo, os vetores são escolhidos à mão, de propósito, só para deixar o cálculo verificável, num Transformer real eles viriam de um embedding de entrada, geralmente já aprendido antes, com centenas ou milhares de posições, não duas.
Os quatro embeddings, então, são:
Pessoa | Embedding |
Carla | (1, 0) |
Ana | (0, 1) |
Bruno | (1, 1) |
Diego | (−1, 1) |
Simplificando Q, K e V para este exemplo
A fórmula de attention pede três transformações diferentes do embedding original, Q (pergunta), K (chave), V (valor), cada uma vinda de uma matriz de peso própria, treinável. Para manter o exemplo pequeno, e rastreável à mão, vamos usar Q=K=V, os próprio embeddings, sem transformação nenhuma, isso equivale a dizer que as três matrizes de peso são a identidade. Num Transformer real, treinado, essas três matrizes seriam diferentes entre si, e ajustadas durante o treino, mas o mecanismo de cálculo, a partir daqui, é exatamente o mesmo.
A matriz de scores, calculada para todo mundo de uma vez
Attention não calcula a atenção de uma pessoa por vez, calcula todo mundo contra todo mundo, de uma só vez, produzindo uma matriz 4x4 inteira. Cada posição (i,j) é o produto interno entre a pergunta de i e a chave de j, dividido pela raiz da dimensão dos vetores (aqui, 2):
de \ para | Carla | Ana | Bruno | Diego |
Carla | 0,707 | 0,000 | 0,707 | −0,707 |
Ana | 0,000 | 0,707 | 0,707 | 0,707 |
Bruno | 0,707 | 0,707 | 1,414 | 0,000 |
Diego | −0,707 | 0,707 | 0,000 | 1,414 |
Cada linha representa "a pergunta dessa pessoa contra a chave de todo mundo". A diagonal (uma pessoa contra si mesma) costuma ter os maiores scores, porque o produto interno de um vetor com ele mesmo tende a ser alto, é o caso de Bruno (1,414) e Diego (1,414 ), os dois maiores valores de toda a matriz.
A matriz de pesos, depois do softmax
O softmax é aplicado linha por linha, não na matriz inteira de uma vez, porque cada linha representa a distribuição de atenção de uma pessoa específica, independente das outras, e cada linha precisa somar 1.
de \ para | Carla | Ana | Bruno | Diego |
Carla | 0,365 | 0,180 | 0,365 | 0,089 |
Ana | 0,141 | 0,286 | 0,286 | 0,286 |
Bruno | 0,221 | 0,221 | 0,449 | 0,109 |
Diego | 0,065 | 0,266 | 0,131 | 0,539 |
Olhando a linha de Ana, especificamente, Carla recebe um peso bem menor (0,141), porque sua representação é "incompatível" com a pergunta de Ana, o produto interno entre os dois vetores deu exatamente zero. Ana, Bruno e Diego, todos igualmente compatíveis com a pergunta de Ana, dividem o resto do peso igualmente entre si.
Repare que a matriz de pesos não é simétrica. Bruno presta bastante atenção em si mesmo (0,449, o maior peso da linha dele), refletindo o alto score que seu vetor tem consigo mesmo. Diego também se autoatende fortemente (0,539). Já Carla e Ana distribuem a própria atenção de forma mais espalhada entre as outras pessoas. Essa assimetria é impossível de enxergar olhando só a linha de uma pessoa, isolada, ela só aparece quando se olha a matriz inteira, lado a lado.
As quatro representações atualizadas, todas de uma vez
Multiplicando a matriz de pesos pelos valores (V, aqui idênticos aos embeddings originais), cada pessoa recebe uma nova representação, a soma ponderada de todo mundo, segundo a própria linha de pesos:
Pessoa | Embedding |
Carla | (0,642, 0,635) |
Ana | (0,141, 0,859) |
Bruno | (0,561, 0,779) |
Diego | (−0,343, 0,935) |

No gráfico acima, dá para ver, visualmente, um padrão que os números já sugeriam: Carla e Diego, que tinham as representações originais mais "extremas" (mais distantes da média do grupo), são quem mais se deslocam depois da camada de attention, puxados na direção do centro de massa ponderado da conversa. Ana, que já começava mais "central" (parecida com a combinação dos outros), quase não se move.
A diferença fundamental em relação ao Artigo 9
No exemplo de message passing do artigo anterior, cada pessoa só agregava seus vizinhos diretos na estrutura em caminho, Ana só agregava Carla e Bruno, por exemplo. Aqui, essa matriz de pesos é, literalmente, uma matriz de adjacência, só que densa (todo mundo ligado a todo mundo) e com pesos contínuos, calculados por uma conta, em vez da matriz esparsa, de 0s e 1 s, que usamos desde o Artigo 1. Attention não abandona a ideia de grafo que atravessou esta série inteira, ela generaliza a matriz de adjacência, de fixa para aprendida.
Por que isso importa, para além de curiosidade teórica
Essa equivalência não é só elegante, ela é prática. Significa que técnicas desenvolvidas para grafos, tudo que construímos nesta série, centralidade, comunidades, o Laplaciano, se aplicam, com adaptação, ao estudo de porque um Transformer presta atenção onde presta. E significa que a arquitetura de Transformer, criada originalmente para texto, se generaliza diretamente para dado que já é um grafo de verdade, moléculas, redes sociais, malhas de transporte, sem precisar reinventar o mecanismo, só trocando o grafo completo padrão por um grafo esparso, com máscara de atenção restrita aos vizinhos reais, uma técnica chamada Graph Transformer, o ponto de encontro final entre as duas famílias de arquitetura que esta série percorreu.
Fechando a jornada
Começamos, no Artigo 1, com a ideia mais simples possível, uma rede é uma matriz. Terminamos aqui, mostrando que a arquitetura de IA mais usada do momento é, ela também, uma matriz, uma matriz de adjacência aprendida, calculada, a cada passagem, por um mecanismo de compatibilidade entre pares. No meio do caminho, autovalores revelaram importância (PageRank) e fragilidade estrutural (Laplaciano), passeios aleatórios viraram.
No Volume III, Teoria das Redes, desenvolvo os funamentos da Teoria das Redes e no Volume VI o conceito de Atenção e os Transformers.

Comentários