
9 - Grafos e Machine Learning: Message passing - a matemática por trás das Graph Neural Networks
Agrupamento espectral e Girvan-Newman, os dois métodos que vimos no artigo anterior, resolvem "como agrupar nós" de forma fixa e analítica. A fórmula não muda, não importa a rede, você calcula autovetores do Laplaciano, ou remove links por intermediação, sempre da mesma maneira, sem nenhum ajuste guiado por dado.
Isso levanta a pergunta natural que fecha essa parte da série: e se, em vez de uma fórmula fixa, a forma de combinar informação dos vizinhos pudesse ser aprendida, ajustada a partir de exemplos, como qualquer outro parâmetro de uma rede neural comum?
É essa a ideia central por trás das Graph Neural Networks (GNNs), e o mecanismo que torna isso possível se chama message passing.
“Message passing"
A ideia é simples de enunciar, mesmo antes de qualquer fórmula. Cada nó manda uma "mensagem" para os vizinhos (ou recebe mensagens deles), agrega essas mensagens recebidas, junto com sua própria informação, e atualiza sua própria representação com base nisso. Repetir esse processo por várias camadas, empilhadas uma sobre a outra, é, literalmente, o que uma Graph Neural Network faz.
Repare no paralelo direto com os artigos anteriores. A operação

do Artigo 7, já segue exatamente as mesmas três etapas de uma camada de message passing, só que numa versão fixa, sem nada treinável.
A mensagem que cada vizinho j manda é o próprio valor, fj. A agregação é a soma das diferenças. E a atualização... não existe, o resultado agregado já é a saída final, sem nenhuma transformação, nenhum peso, nenhuma não-linearidade.
A novidade agora é dar à etapa de atualização os parâmetros que faltavam, um peso W, um viés b, uma não-linearidade σ, tornando ajustável, via treino, algo que antes era uma fórmula fixa como D−A.
Formalizando a regra de atualização
Uma camada de message passing, para o nó i, segue três etapas.
Mensagem: cada vizinho j de i prepara uma mensagem, geralmente uma função da própria representação atual, mⱼ = hⱼ (na versão mais simples, a mensagem é só o próprio valor do vizinho).
Agregação: as mensagens de todos os vizinhos são combinadas, numa soma, média, ou máximo, numa operação que precisa ser a mesma independente de quantos vizinhos existirem (uma rede social real tem gente com 5 conexões e gente com 5 mil, a agregação precisa lidar com os dois casos sem mudar de fórmula).
Atualização: o resultado agregado, combinado com a própria representação anterior do nó, passa por uma transformação treinável (tipicamente uma camada linear, com peso W e viés b, seguida de uma não-linearidade, como ReLU). Em forma isolada:

é uma transformação linear comum, a mesma operação de qualquer camada densa de rede neural, W é uma matriz de pesos, b é um vetor de viés, os dois ajustados durante o treino.
σ(…) é a não-linearidade (ReLU, tanh, etc.), aplicada por último, a mesma função de ativação de qualquer rede neural convencional.
E hi(novo) é a representação atualizada do nó i, que vira a entrada da próxima camada (se houver outra empilhada em cima).
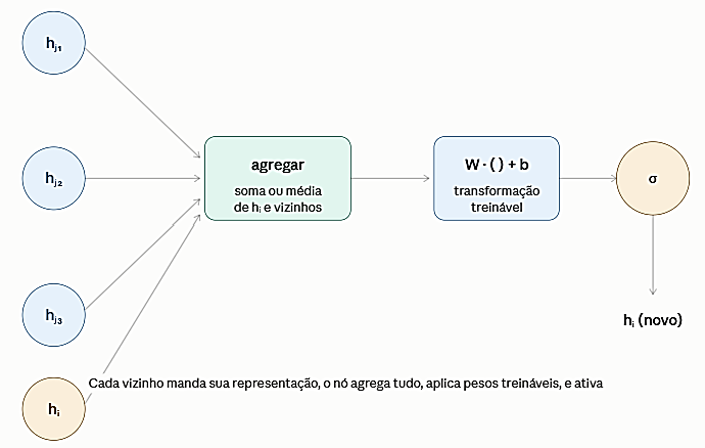
O fluxo fica visível da esquerda para a direita: os três vizinhos (hj1,hj2,hj3) e o próprio nó (hi) entram na caixa de agregação, o resultado passa pela transformação treinável W⋅( )+b, os mesmos pesos que o gradient descent ajusta durante o treino), depois pela não-linearidade σ, produzindo a representação atualizada, hi(novo), que é exatamente o número (ou vetor) que vira entrada da próxima camada, se houver outra empilhada em cima.
Compare isso com o que já vimos. Node2Vec (Artigo 6) fixava a "vizinhança relevante" através de um passeio aleatório específico, com parâmetros p e q escolhidos manualmente. O Laplaciano (Artigo 7) fixava a forma de agregação através de D−A, uma soma de diferenças, sem peso treinável nenhum. Aqui, tanto a vizinhança relevante quanto a forma de combinar informação podem, em princípio, ser aprendidas, tornando o mecanismo muito mais flexível, ao custo de precisar de dado rotulado para treinar esses parâmetros.
Um exemplo pequeno
Reaproveitando a rede em caminho "Carla"-"Ana"-"Bruno"-"Diego", com os valores de opinião que já usamos, f = (3, 4, 9, 6), vamos rodar uma camada de message passing à mão.

Usando agregação por média (do próprio nó mais os vizinhos), e uma transformação linear simples, com W=2 e b=−1:
Nó | Vizinhos | Agregado (média) | Hnovo = 2 × agregado − 1 |
Carla | Ana | (3+4)/2 = 3,50 | 6,00 |
Ana | Carla, Bruno | (4+3+9)/3 = 5,33 | 9,67 |
Bruno | Ana, Diego | (9+4+6)/3 = 6,33 | 11,67 |
Diego | Bruno | (6+9)/2 = 7,50 | 14,00 |
Como todos os resultados já saíram positivos, a ReLU não muda nada aqui (ela só zeraria valores negativos). O ponto central do exemplo não é o número final, é o mecanismo, cada nó combinou sua própria informação com a dos vizinhos diretos, através de uma transformação com parâmetros (W, b) que, num treino real, seriam ajustados por gradient descent, o mesmo algoritmo que já formalizamos, com bastante detalhe, em outro artigo desta coleção, para minimizar o erro do modelo inteiro, não escolhidos à mão como fizemos aqui.
As arquiteturas mais conhecidas, e a diferença entre elas
GCN (Graph Convolutional Network) é a mais próxima do Laplaciano que já vimos, sua regra de agregação usa, essencialmente, uma versão normalizada de D elevado a menos um meio, vezes A, vezes D elevado a menos um meio, uma bagagem direta do Artigo 7, só que agora dentro de uma camada treinável.
GraphSAGE foi pensada para redes muito grandes, onde agregar todos os vizinhos de cada nó, a cada camada, é computacionalmente inviável. Em vez disso, amostra um subconjunto fixo de vizinhos por nó, trocando precisão por escalabilidade, útil quando a rede tem milhões de nós.
GAT (Graph Attention Network) não trata todos os vizinhos igualmente, ela aprende um peso de atenção diferente para cada vizinho, decidindo, de forma treinável, quais conexões merecem mais influência na atualização. Isso é o gancho direto para o próximo artigo desta série, porque esse mecanismo de atenção é, estruturalmente, o mesmo usado em Transformers.
O problema do over-smoothing
Empilhar camadas de message passing tem um limite prático. Depois de muitas camadas, cada nó já "ouviu", indiretamente, praticamente toda a rede, e as representações de nós diferentes começam a ficar parecidas demais entre si, perdendo a informação que os distinguia originalmente. Esse fenômeno se chama over-smoothing.
A ligação com o Artigo 7 é direta, é o mesmo tipo de convergência para consenso que já vimos na equação:

em que, dado tempo suficiente, todos os nós convergem para a mesma opinião média. Lá, essa convergência era o objetivo (modelar como uma opinião se espalha até o equilíbrio). Aqui, é um efeito colateral indesejado, você quer que cada nó aprenda uma representação distintiva, não que todos convirjam para o mesmo ponto. Por isso, GNNs na prática raramente usam mais de duas ou três camadas empilhadas, mesmo quando a rede é muito maior que isso.
Onde isso se conecta com o mundo real, e com Machine Learning
Previsão de propriedades moleculares, cada átomo de uma molécula é um nó, cada ligação química é um link, e uma GNN aprende a prever propriedades (toxicidade, solubilidade, eficácia de um remédio candidato) direto da estrutura molecular, sem precisar de fórmula química fixa nenhuma.
Sistemas de recomendação em escala, empresas como Pinterest usam GraphSAGE para gerar recomendações sobre grafos com bilhões de nós, escala impossível para os métodos analíticos fixos que vimos até aqui.
Detecção de fraude, generalizando tudo que já vimos com Laplaciano e comunidades, agora aprendendo a própria regra de agregação a partir de casos rotulados de fraude conhecida, em vez de fixar de antemão o que conta como "comportamento anômalo".
Continue essa jornada matemática
No próximo, e último, artigo desta série, "Attention é um grafo: a matemática que une Transformers e redes", vamos mostrar que o mecanismo de atenção do GAT, que só citamos de passagem aqui, é, estruturalmente, o mesmo mecanismo por trás dos Transformers, a arquitetura que sustenta os modelos de linguagem mais usados hoje, fechando o círculo entre teoria de grafos e o estado da arte em IA.
No Volume III, Teoria das Redes, desenvolvo os funamentos da Teoria das Redes e no Volume VI o conceito de Atenção e os Transformers.

Comentários