
8 - Grafos e Machine Learning: Comunidades em redes - a matemática de dividir sem perder informação
Recapitulando: onde o Laplaciano já nos levou
No artigo anterior desta série, vimos que o Laplaciano, aplicado a um vetor de estado f, revela dois sinais diferentes, e igualmente úteis, sobre uma rede.
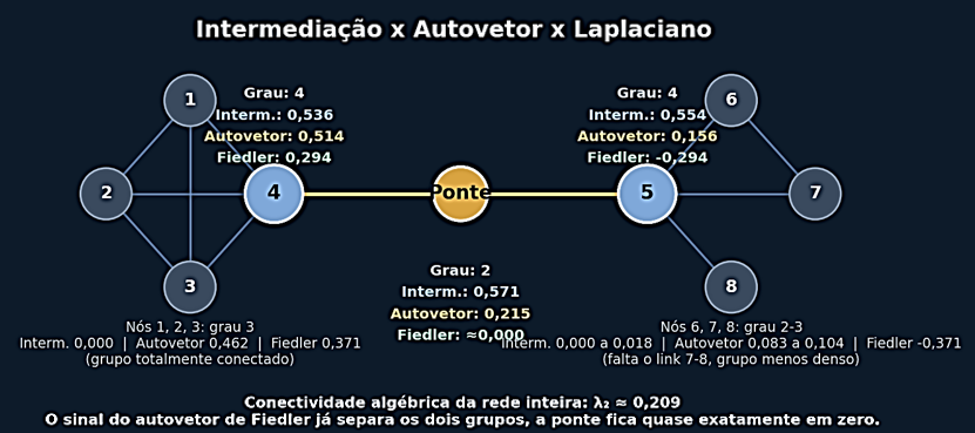
Numa câmara de eco, se todos os nós tivessem a mesma opinião, o cálculo de Lf daria zero para todo mundo. Ninguém destoa, a rede está em consenso completo, e é exatamente esse zero generalizado que serve de assinatura matemática de uma bolha, todo mundo repete o mesmo discurso, sem nenhum fluxo de opinião contrária entrando ou saindo do grupo.
Na detecção de fraude, trocando "opinião" por "valor médio de transação" numa conta bancária, uma conta com fluxo de dinheiro muito maior que a média das contas conectadas a ela gera um pico positivo grande em Lf, o sinal que um sistema antifraude usa para marcar uma conta suspeita, um possível hub de lavagem, que não se comporta como a própria vizinhança.
Repare no que essas duas aplicações têm em comum, e no que falta nelas. As duas usam o Laplaciano para julgar um nó por vez, "essa pessoa destoa?", "essa conta é anômala?". Nenhuma das duas responde a uma pergunta mais ambiciosa, que já apareceu no fim do artigo anterior, quando o autovetor de Fiedler, sozinho, separou a rede de dois clusters em dois grupos coesos, só olhando o sinal de cada entrada: existe um método geral para dividir uma rede inteira em grupos, não só detectar quem destoa individualmente, mas encontrar a própria estrutura de comunidades escondida nela?
É essa pergunta que este artigo responde, e ela tem, na verdade, duas respostas matemáticas diferentes, que vamos comparar.
Dividir uma rede é mais difícil do que parece
Separar n nós em k grupos parece um problema simples, até você tentar contar quantas divisões diferentes existem. Para uma rede de apenas 12 nós, divididos em 3 grupos, já existem mais de 250 mil formas diferentes de fazer essa divisão. Testar todas, uma por uma, não é opção computacional para redes reais, com milhares ou milhões de nós.
Além do problema de escala, existe um problema conceitual, o que significa "melhor divisão"? Sem um critério matemático objetivo, qualquer agrupamento pode parecer razoável, dependendo de quem está olhando o desenho da rede.
Primeira resposta: generalizando o autovetor de Fiedler
No Artigo 7, usamos um único autovetor (o associado a λ2) para separar a rede em dois grupos, pelo sinal de cada entrada. A generalização natural é usar os k−1 primeiros autovetores não-triviais do Laplaciano, para representar cada nó como um ponto num espaço de k−1 dimensões.
A ideia central do agrupamento espectral (spectral clustering) é que, nesse novo espaço, nós da mesma comunidade ficam próximos entre si, mesmo sem link direto, porque o Laplaciano já capturou, nesses autovetores, a estrutura de conectividade da rede inteira, não só as conexões imediatas de cada nó.
O algoritmo, passo a passo
Calcule o Laplaciano L=D−A da rede.
Extraia os k autovetores associados aos k menores autovalores (pulando o autovetor trivial de λ1=0).
Monte uma matriz onde cada linha é um nó, "embutido" num espaço de k dimensões.
Rode um algoritmo de agrupamento simples (k-means) sobre esses pontos.
Um exemplo com três comunidades
Considere uma rede de 12 nós, três grupos densos de 4 nós cada (grafo completo dentro de cada grupo), ligados entre si por três links fracos, formando um triângulo entre os grupos. Os primeiros autovalores do Laplaciano:

Os três grupos (A, B, C) aparecem completos internamente (todo mundo ligado a todo mundo dentro do próprio grupo, em azul), com os nós de conexão destacados em dourado, ligados pelas três pontes fracas que formam o triângulo.

λ2 e λ3 saem praticamente empatados, sinal de que a rede tem duas direções de fragilidade estrutural, consistente com existirem três grupos, não dois. Usando os autovetores de λ2 e λ3 como coordenadas, e rodando k-means pedindo 3 grupos, o resultado recupera exatamente os três grupos originais, sem erro nenhum.
Note que a rede tem 12 nós, então o Laplaciano é uma matriz 12x12, e produz 12 autovalores, não 6. Mostramos os seis primeiros (os menores), porque são os únicos que carregam informação relevante para a pergunta "quantos grupos existem, e quão fracas são as divisões entre eles". Os seis maiores (4 mais duas vezes, 5,4495 duas vezes, e 6) existem, mas não acrescentam nada à história de comunidades, são "ruído estrutural" de mais alta frequência, ligado a detalhes internos de cada grupo, não à divisão entre eles.
O que cada um dos seis primeiros significa, especificamente
λ1=0: sempre existe, em qualquer rede conectada, não conta nada sobre esta rede em particular, só confirma que a rede inteira é um único componente (nenhum grupo totalmente isolado dos outros).
λ2 ≈0,5505: a primeira direção de fragilidade estrutural, o "corte" mais barato que separa a rede em dois pedaços. Aqui, provavelmente separa um dos três grupos dos outros dois juntos.
λ3 ≈0,5505: quase empatado com λ2, essa é a peça-chave da resposta. Quando dois autovalores pequenos aparecem juntos, é sinal de que existe mais de uma forma de cortar a rede de forma barata, não um único gargalo, mas uma estrutura com múltiplos pontos fracos, exatamente o que esperamos de três grupos (em vez de dois), já que dá para separar "grupo A dos outros dois" ou "grupo B dos outros dois" com custo parecido.
λ4=λ5=λ6=4: aqui a informação sobre comunidade já acabou, esses três autovalores, exatamente empatados em 4, refletem a simetria interna de cada grupo (K4 completo), não a relação entre os grupos. É por isso que o algoritmo de agrupamento espectral usa só os autovetores de λ2 e λ3 como coordenadas, e ignora os autovalores de λ4 em diante, eles não ajudam a encontrar as três comunidades, só descrevem a "textura" interna de cada uma.
A regra geral por trás disso é que para dividir uma rede em k comunidades, você usa os k−1 primeiros autovalores não-triviais (depois do zero garantido). Aqui, k=3 comunidades, então usamos λ2 e λ3, exatamente dois autovalores, nem mais, nem menos. Se a rede tivesse 4 comunidades bem definidas, esperaríamos ver três autovalores pequenos e próximos entre si (não só dois), antes de um salto grande até o próximo grupo de autovalores.
Vimos os autovalores (números globais da rede), não os autovetores por nó (as coordenadas que cada nó recebe). São coisas diferentes, vale calcular.
As coordenadas espectrais, nó por nó
Nó | Grupo | coord. λ2 | coord. λ3 |
1 | A | 0,000 | −0,344 |
2 | A | −0,099 | −0,453 |
3 | A | −0,099 | −0,453 |
4 | A | −0,144 | −0,312 |
5 | B | −0,298 | 0,172 |
6 | B | −0,343 | 0,312 |
7 | B | −0,343 | 0,312 |
8 | B | −0,199 | 0,281 |
9 | C | 0,298 | 0,172 |
10 | C | 0,442 | 0,140 |
11 | C | 0,442 | 0,140 |
12 | C | 0,343 | 0,032 |
Cada nó, que antes era só um ponto numa rede (com links para outros nós), agora virou um ponto num plano cartesiano, com coordenada x (autovetor de λ2) e coordenada y (autovetor de λ3). É exatamente esse par de números que o k-means usa para agrupar, ele nunca vê a rede original, só esses dois números por nó.
Repare no padrão, os quatro nós do Grupo A (1, 2, 3, 4) têm coordenada λ3 sempre negativa, e próxima entre si (−0,344 a −0,453). Os quatro nós do Grupo B (5, 6, 7, 8) têm coordenada λ2 sempre negativa, e coordenada λ3 sempre positiva. Os quatro nós do Grupo C (9, 10, 11, 12) têm as duas coordenadas positivas. Cada grupo ocupa uma região diferente do plano, sem sobreposição, exatamente por isso o k-means consegue separar os três corretamente, sem margem de erro.

Um detalhe interessante, que vale destacar é que os nós 2 e 3 têm coordenadas idênticas (−0,099, −0,453), o mesmo acontece com 6 e 7 (−0,343, 0,312), e com 10 e 11 (0,442 , 0,140). Isso não é coincidência nem erro de arredondamento, é simetria estrutural pura, dentro de cada grupo completo, os nós que não tocam a ponte de saída são estruturalmente intercambiáveis, a rede não tem como distinguir matematicamente o nó 2 do nó 3, eles têm exatamente o mesmo padrão de conexões, então recebem exatamente a mesma coordenada espectral.
Note que o sinal, sozinho, não significa nada fixo, ele só serve para separar grupos uns dos outros, não indica "grupo bom" ou "grupo ruim", nem tem uma direção universal como positivo/negativo tinha no exemplo do Artigo 7.
Como escolher k, antes de rodar o algoritmo
No agrupamento espectral você precisa decidir k antes de extrair os autovetores. Existem algumas formas de tomar essa decisão.
A mais direta é o "salto do autovalor" (eigengap heuristic), olhe a lista de autovalores ordenados, e procure o maior salto entre um e o seguinte. Nos nossos 12 autovalores, o salto de 0,505 para 4 é enorme, muito maior que qualquer outro salto na lista, e o número de autovalores antes desse salto grande (λ1, λ2, λ3, ou seja, dois autovalores não-triviais) indica k=3, o resultado que já usamos. Autovalores pequenos, antes do salto, representam divisões baratas da rede, comunidades genuínas. Autovalores grandes, depois, representam variação interna de cada grupo, não separação real entre eles.
Outras formas incluem testar vários valores de k e escolher o de maior modularidade (o critério que veremos a seguir), usar conhecimento de domínio quando você já sabe quantos grupos esperar, ou aplicar métricas genéricas de qualidade de agrupamento, como o coeficiente de silhueta, sobre os pontos já embutidos no espaço espectral.
Segunda resposta: modularidade e o algoritmo de Girvan-Newman
Existe um caminho completamente diferente para o mesmo problema, que não usa autovalor nenhum.
A modularidade
A modularidade (Q) mede o quanto uma divisão de uma rede em comunidades é melhor do que uma divisão aleatória, comparando o número real de conexões dentro de cada grupo com o número esperado se a rede fosse embaralhada ao acaso, respeitando o grau de cada nó.
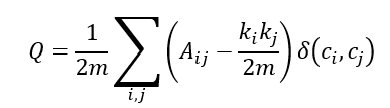
onde m é o número total de links, ki e kj são os graus dos nós i e j, e δ(ci,cj) vale 1 se os dois nós estão na mesma comunidade, 0 caso contrário. Q próximo de 0 significa que não há estrutura de comunidade clara, próximo de 1, uma estrutura comunitária muito forte.
Um exemplo direto disso, já desenvolvido no Volume III desta coleção: uma rede pequena, com estrutura modular real, tem Q=0,5444. A mesma rede, com os links reembaralhados aleatoriamente (mantendo o mesmo grau de cada nó), cai para Q=0,2838, prova numérica de que a modularidade cai quando a estrutura de comunidade genuína desaparece.

O algoritmo de Girvan-Newman
A ideia central é que links conectando comunidades diferentes tendem a aparecer em muitos dos caminhos mais curtos da rede, alta centralidade de intermediação, atuando como pontes entre grupos.
Calcule a intermediação de todos os links da rede.
Remova o link (ou links) de maior intermediação.
Recalcule a intermediação para a rede restante.
Repita até a rede se dividir em componentes distintos.

Ao eliminar progressivamente os links mais "inter-comunitários", o método revela a estrutura hierárquica das comunidades, da divisão mais global até as subdivisões mais finas. Diferente do agrupamento espectral, você não precisa decidir k antes, o algoritmo gera uma sequência inteira de partições possíveis, cada uma com seu próprio Q, e você escolhe a divisão com maior modularidade entre elas.
Validação com dado real: Zachary Karate Club
Como exemplo, o algoritmo foi aplicado ao conjunto de dados Zachary Karate Club, identificando efetivamente duas comunidades distintas dentro do clube. Você pode explorar uma implementação detalhada deste algoritmo usando Python.
Para gerar os resultados abaixo:
Usamos a rede do Clube de Karatê (um conjunto de dados bem conhecido de amizades em um clube de karatê).
O algoritmo de Girvan–Newman remove progressivamente links com a maior intermediação.
Após a primeira divisão, a rede é dividida em 2 comunidades.
Após a segunda divisão, é dividida ainda mais.
Calculamos a modularidade (Q) para ver qual divisão captura melhor a estrutura da comunidade.

Vemos que com 4 partições obtemos a modularidade mais alta (0,3850).
Vale notar que o Zachary Karate Club também é famoso por ter se dividido, na vida real, em duas facções rivais, um resultado diferente da partição de maior modularidade que encontramos aqui, um lembrete de que 'melhor divisão matemática' e 'divisão que realmente aconteceu' nem sempre coincidem.
Note que o algoritmo de Girvan–Newman não garante que a modularidade aumente monotonicamente a cada divisão. Em vez disso, ele remove links com base na intermediação de links, gerando partições sucessivas. Para cada partição, ele calcula a modularidade Q. Frequentemente, as primeiras ou segundas partições dão o Q máximo, e após mais remoções, a rede se fragmenta demais e a modularidade geralmente cai.
Em um estudo intitulado "Communities Based on Network Topology" por Wei Liu, Matteo Pellegrini e Xiaofan Wang , os autores conduziram uma análise de 16 tipos diferentes de redes. Eles compararam as partições usando vários algoritmos populares para detecção de comunidades. Na rede de futebol universitário dos EUA (figura abaixo), as 11 comunidades detectadas são idênticas às 11 conferências reais, exceto pelas 8 equipes independentes, que são atribuídas a 3 conferências diferentes, respectivamente.

Observe que os nós sobrepostos em redes se referem a nós que pertencem a múltiplas comunidades (clusters) simultaneamente. Este conceito é comum em redes do mundo real, como redes sociais, onde indivíduos podem participar de múltiplos grupos ou comunidades. Por exemplo, em uma rede social, uma pessoa pode pertencer a um grupo "família" e a um grupo "trabalho". Em redes biológicas, uma proteína pode participar de múltiplos módulos funcionais.
Espectral vs. Girvan-Newman: quando usar cada um
Os dois métodos partem de lógicas matemáticas completamente diferentes, um usa autovalor e distância num espaço geométrico, o outro usa intermediação e remoção sequencial de link, e ainda assim, na rede de três comunidades que testamos, os dois convergem para a mesma resposta.
O agrupamento espectral exige que você decida k antes de rodar, e seu custo cresce rápido com o tamanho da rede, calcular autovetores de uma matriz grande não é barato. Girvan-Newman não exige k de antemão, ele mesmo gera a sequência de partições possíveis, mas recalcular intermediação a cada remoção de link também é caro computacionalmente, sendo geralmente inviável para redes muito grandes.
Na prática, redes pequenas ou médias, onde entender a hierarquia completa de divisões interessa, favorecem Girvan-Newman. Redes grandes, onde k já é conhecido ou estimável de antemão, favorecem agrupamento espectral.
Uma limitação que os dois métodos compartilham
Tanto agrupamento espectral quanto Girvan-Newman produzem partições rígidas, cada nó pertence a exatamente uma comunidade. Isso não reflete bem redes reais, onde é comum um nó pertencer, ao mesmo tempo, a mais de um grupo, uma pessoa que participa tanto do grupo "família" quanto do grupo "trabalho", numa rede social, ou uma proteína que participa de múltiplos módulos funcionais, numa rede biológica. Detectar essas comunidades sobrepostas exige uma classe de algoritmo diferente, fora do escopo deste artigo, mas vale ter em mente, antes de tratar qualquer partição rígida como a verdade absoluta sobre a estrutura de uma rede.
Onde isso se conecta com Machine Learning
Detecção de fraude organizada, um grupo de contas que só transaciona entre si é exatamente o tipo de estrutura que agrupamento de comunidade detecta automaticamente, sem regra manual.
Segmentação de clientes, sem depender de atributos demográficos, deixando a estrutura da própria rede de interações revelar os segmentos.
Comunidade como variável categórica nova, o rótulo de cada nó, depois de detectado, vira uma coluna pronta para qualquer modelo supervisionado seguinte, o mesmo espírito do Node2Vec, do Artigo 6.
Continue essa jornada matemática
No próximo artigo desta série, "Message passing: a matemática por trás das Graph Neural Networks", veremos como redes neurais modernas generalizam essa mesma ideia, cada nó atualizando sua própria representação a partir dos vizinhos, repetidamente, aprendendo de forma treinável o que agrupamento espectral e Girvan-Newman fazem de forma fixa e analítica.
No Volume III, Redes, desenvolvo modularidade, Girvan-Newman e agrupamento espectral com mais profundidade, incluindo comunidades sobrepostas e o intervalo interpretativo completo de Q.

Comentários