
LLMs Não Calculam, Elas Preveem: Por Que o Humano Continua no Loop
Os Modelos de Linguagem Arquitetados como Transformers (LLMs) não possuem uma "calculadora" interna por padrão. Eles são, na sua essência, motores estatísticos de previsão de próximo token, seja ele uma palavra, um número ou um símbolo. Entender essa diferença muda a forma como se deve confiar (ou desconfiar) de um resultado numérico saído de um chat, e como vamos ver no final deste artigo, ela também explica por que o avanço mais espetacular da IA em matemática até hoje ainda depende, e muito, de revisão humana.
Como um LLM lida com matemática
Previsão estatística. Quando você pergunta quanto vale "2 + 2", o modelo responde "4" não porque somou duas unidades a outras duas, mas porque viu o padrão "2 + 2 = 4" bilhões de vezes durante o treinamento e calculou que "4" é a continuação estatisticamente mais provável para aquela sequência de tokens.
Memorização e padrões. Para contas simples ou operações comuns, o modelo acerta por conta da vasta quantidade de dados memorizados e de padrões reconhecidos, não por executar uma soma.
Limitação com números grandes. Ao tentar resolver equações complexas ou multiplicar números de dez dígitos inéditos, o modelo costuma errar, ou "alucinar", porque tenta prever o resultado com base em semelhança de padrão, em vez de aplicar um algoritmo aritmético passo a passo.
Exemplo 1: quando a previsão acerta
Pergunta: "Quanto é 17 × 23?". Essa é uma conta pequena, do tipo que aparece repetidamente em material de treino, então a distribuição de probabilidade sobre o próximo token fica concentrada na resposta certa.
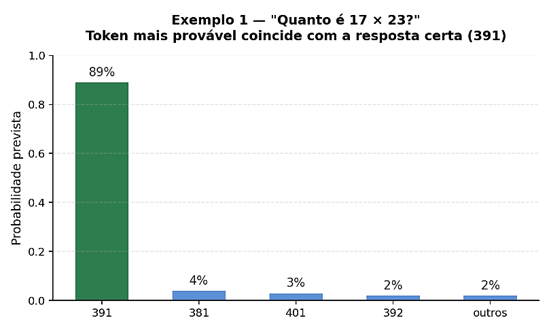
(Valores ilustrativos, para fins didáticos, não são a saída real de um modelo específico.)
Uma calculadora chega no mesmo "391" por um caminho completamente diferente, aplicando um algoritmo determinístico:
```
17 × 23 = 17 × (20 + 3)
= 17 × 20 + 17 × 3
= 340 + 51
= 391
```
O resultado final coincide, mas o processo que gerou cada um é de outra natureza. Um é busca por semelhança estatística, o outro é execução de regra fixa.
Exemplo 2: quando a previsão falha
Pergunta: "Quanto é 4.827 × 6.193?". Aqui o modelo perde o apoio da memorização. É uma combinação de dígitos rara, provavelmente inédita no treino, então a rede precisa "estimar visualmente" a forma da resposta em vez de recuperar um padrão já visto.

(Valores ilustrativos, para fins didáticos, não são a saída real de um modelo específico.)
Neste exemplo, a resposta certa (29.893.611) nem sequer é o token mais provável segundo o modelo, fica atrás de uma alternativa que "parece" plausível mas está errada. É exatamente esse tipo de caso, números grandes e pouco frequentes, que produz os erros aritméticos mais comuns em LLMs.
Por que essa distinção importa na prática
A importância disso está diretamente ligada à natureza matemática de cada processo, não é só uma curiosidade sobre arquitetura.
Uma calculadora executa uma função determinística. Dado o mesmo par de números, "17 × 23" sempre produz "391", sem exceção, porque o algoritmo aplica regras fixas de aritmética. O erro, quando existe, vem só de limitação de representação numérica, é um erro conhecido, limitado e previsível.
Um LLM estima uma distribuição de probabilidade condicional. A cada token, ele calcula P(próximo token | contexto), uma probabilidade sobre dezenas de milhares de possibilidades, e escolhe (ou sorteia, dependendo da "temperatura" usada) o mais provável.
Dado o contexto (todos os tokens já gerados até a posição t−1), o modelo calcula, para cada token possível i do vocabulário V, um "logit" zi, um número bruto produzido pela última camada da rede. A probabilidade de escolher o token i como próximo é dada pela função "softmax" aplicada a esses logits:

onde a soma no denominador percorre todos os j do vocabulário V (tipicamente dezenas de milhares de tokens). O "softmax" faz duas coisas ao mesmo tempo: transforma qualquer conjunto de números reais em valores positivos que somam 1 (uma distribuição de probabilidade válida), e amplifica a diferença entre os valores mais altos e os mais baixos, o que faz o token de maior logit dominar a distribuição quando o modelo está "confiante".
Para gerar uma sequência inteira, o modelo aplica essa mesma fórmula token a token, condicionando cada nova previsão em tudo o que já foi gerado antes, o que corresponde à regra da cadeia de probabilidade:
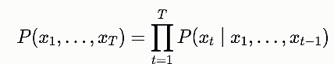
Um detalhe que vale mencionar junto, porque explica o comportamento observado no Exemplo 2: existe um parâmetro chamado "temperatura" (τ) que controla o quanto a distribuição fica concentrada ou espalhada, dividindo os logits antes do softmax:

Com τ baixo, o modelo quase sempre escolhe o token de maior probabilidade (comportamento determinístico na prática). Com τ mais alto, a escolha fica mais aleatória mesmo entre tokens de probabilidade parecida, o que é o mecanismo que produz respostas diferentes para a mesma pergunta em execuções distintas, algo que nunca acontece com uma calculadora.
Isso significa que o resultado não tem garantia algébrica nenhuma. Não existe um teorema que diga "se a entrada está correta, a saída está correta", como existe para a multiplicação. O que existe é uma correlação estatística aprendida a partir de exemplos, e correlação não é o mesmo que prova.
É por isso que o erro de um LLM em matemática se comporta de um jeito perigoso: ele não avisa. Uma calculadora, se não tem capacidade para um número muito grande, retorna erro ou "overflow", ela sabe que não sabe. Um LLM, no Exemplo 2, devolve "29.884.211" com a mesma fluência e a mesma confiança visual de quando acerta "391" no Exemplo 1. A distribuição de probabilidade por trás pode estar espalhada, mas isso fica invisível para quem só lê o texto de resposta. O modelo não expõe sua própria incerteza a menos que se olhe para os "logprobs" ou para a distribuição completa, algo que a interface de chat normal não mostra.
Para quem trabalha com dados, essa é a razão concreta para nunca tratar um número saído de um LLM puro como se fosse saída de uma função determinística, mesmo quando parece certo. Esse é o motivo pelo qual a integração com execução de código resolve o problema na raiz, ela substitui uma estimativa de P(token | contexto) por uma avaliação exata de f(x, y), trocando estatística por álgebra no momento em que o cálculo realmente acontece.
Exemplo 3: quando a ferramenta entra em ação
Vale ver isso acontecendo na prática. Pedi a um assistente de IA com execução de código habilitada para multiplicar "2.222.222.222" por "1.234.567.789", uma conta bem maior que a do Exemplo 2, e sem chance nenhuma de estar memorizada. A resposta veio exata: 2.743.483.975.281.207.158 (aproximadamente 2,74 quintilhões).
Perguntado sobre como chegou nesse valor, o próprio assistente descreveu o processo em quatro etapas:
1. Reconhecimento da necessidade. Ao identificar que a pergunta exigia a multiplicação exata de dois números grandes, o sistema reconheceu que tentar prever os próximos dígitos, como no Exemplo 2, arriscaria uma alucinação matemática.
2. Geração de código. Em vez de tentar calcular via previsão de texto, o modelo gerou automaticamente um script:
```python
a = 2222222222
b = 1234567789
result = a * b
print(f"Result: {result}")
```
3. Execução em ambiente isolado. Esse código foi enviado a um interpretador Python externo para ser executado matematicamente, fora da rede neural.
4. Retorno do resultado. O interpretador devolveu o valor exato, e o modelo apenas formatou e apresentou o número.
Esse é o mesmo mecanismo descrito acima, mas visto de dentro: o modelo deixa de tentar prever o resultado numérico e passa a atuar como orquestrador, reconhecendo o problema, escrevendo o código e delegando o cálculo real para uma linguagem de programação determinística.
Em modelos focados em raciocínio, o sistema aprende a quebrar o problema em etapas lógicas menores, como um humano faria no papel, o que reduz bastante os erros de previsão matemática, mesmo sem sair do modo "prever o próximo token".
Essa mesma lógica,
previsão contra cálculo contra prova verificada
atravessa toda a história recente da matemática assistida por computador.
Por que o humano continua no loop
Do Exemplo 1 ao caso do Problema do Milênio, existe um fio condutor: em nenhum desses casos a máquina fecha o ciclo sozinha.
Na previsão pura (Exemplos 1 e 2), é um humano, ou um sistema construído por humanos, quem precisa saber que não pode confiar cegamente num número que "parece" certo, porque o modelo não avisa quando está espalhando probabilidade entre respostas erradas. Na execução de ferramentas (Exemplo 3), o cálculo em si fica determinístico, mas alguém decidiu, em algum momento, que aquele problema exigia código em vez de previsão, e alguém pode inspecionar o script gerado antes de confiar nele. E nos três episódios que fecho no artigo completo do site, mesmo a demonstração mais sofisticada que uma IA já produziu para um Problema do Milênio segue sem validade oficial até passar pela revisão de matemáticos humanos, porque nem a verificação formal mais rigorosa confirma sozinha se o problema formalizado corresponde de fato à pergunta original.
Da conta de multiplicação à fronteira da matemática, previsão e geração não substituem verificação. Essa é a distinção que dá título a este artigo, e é também a resposta para por que, pelo menos por enquanto, o humano continua no loop.
O limite superior: quando IA tenta provar matemática de verdade
Os exemplos acima envolvem aritmética, contas com resposta certa e única. Mas em setembro de 2026 aconteceu algo que testa essa mesma distinção, entre gerar uma resposta e verificá-la, no nível mais alto da matemática: a tentativa de resolver um dos sete Problemas do Milênio do Clay Mathematics Institute, cada um com prêmio de US$ 1 milhão para quem o resolver.
O que foi anunciado
Em 8 de setembro de 2026, um laboratório de IA divulgou que um de seus modelos internos, ainda não disponível ao público, produziu uma demonstração para o problema da existência e suavidade das equações de Navier-Stokes, que descrevem o movimento de fluidos e são usadas, por exemplo, em previsão do tempo. O problema pergunta se um fluido tridimensional que começa suave e com energia finita permanece suave para sempre, ou se existe algum caso em que ele desenvolve uma singularidade, um ponto onde a velocidade dispara para o infinito em tempo finito. A demonstração construiu justamente esse caso: um fluido inicialmente suave, sob uma força também suave e com energia finita, em que a equação prevê matematicamente uma singularidade em tempo finito.
Vale a pena ser preciso aqui, porque é fácil interpretar isso como "provaram que a equação está errada", e não é bem isso. O resultado não é um erro na equação, é uma resposta ao problema, mostrando que ela não garante comportamento suave em todos os casos permitidos, existe pelo menos um cenário em que a solução "explode".
A IA gerou a ilustração do problema:

Duas ressalvas importam: primeiro, isso é sobre o modelo matemático idealizado, um fluido real nunca atinge velocidade infinita, porque antes disso entram em jogo efeitos que a equação idealizada não capta, como turbulência em escalas muito pequenas; segundo, isso não compromete o uso prático da equação em previsão do tempo, aerodinâmica ou engenharia, que operam longe dessas condições extremas.
Como o processo funcionou
O esforço foi construído em etapas, aumentando a escala aos poucos. Primeiro, cerca de 100 agentes de IA trabalharam por 50 horas numa versão mais simples e relacionada do problema (a equação de Euler), como um teste antes de ir para o alvo principal. Com esse resultado em mãos, a equipe escalou para cerca de 10.000 agentes trabalhando ao mesmo tempo por 88 horas no problema completo de Navier-Stokes, trocando entre si quase 5 milhões de mensagens enquanto exploravam diferentes caminhos de demonstração em paralelo. Pesquisadores humanos acompanharam esse processo, redirecionando o esforço para os caminhos mais promissores e consolidando descobertas entre os grupos, um pouco como um orientador que vai lendo rascunhos parciais de vários pesquisadores ao mesmo tempo e aponta qual direção parece mais promissora, só que em escala muito maior e em tempo real. Depois de obtida a prova candidata, um outro modelo converteu o resultado para "Lean", uma linguagem de verificação formal que checa se cada passo lógico realmente decorre do anterior, sem saltos escondidos, um processo que levou mais 17 horas.
Entretanto, isso ainda não é um problema resolvido, oficialmente. A verificação em Lean confirma consistência lógica interna da demonstração, não substitui a revisão por pares feita por matemáticos, que é o padrão para aceitar um resultado como esse. Até a publicação deste artigo, o problema de Navier-Stokes seguia listado como não resolvido pelo Clay Mathematics Institute, e a comunidade matemática ainda está examinando o material publicado.
Um precedente ainda mais antigo: o Teorema das Quatro Cores
Décadas antes de qualquer LLM existir, a matemática já tinha passado por um episódio parecido, e ele foi o primeiro grande teorema cuja prova dependeu essencialmente de um computador.

O problema, formulado em 1852, pergunta se qualquer mapa pode ser colorido usando só quatro cores, de forma que países vizinhos nunca fiquem com a mesma cor. Kenneth Appel e Wolfgang Haken apresentaram a demonstração em 1976, depois de reduzir o problema a um conjunto de 1.834 "configurações redutíveis" (mais tarde reduzido a 1.482) que precisavam ser checadas uma a uma. Fazer isso à mão era inviável, então o computador verificou cada configuração, num processo que consumiu mais de mil horas de cálculo e foi checado de forma independente em programas e máquinas diferentes. A outra metade da prova, a chamada parte "inevitável", ainda foi conferida manualmente, em mais de 400 páginas de microficha, com a ajuda da filha de Haken, Dorothea.
Na época, isso gerou uma controvérsia genuína: parte da comunidade matemática relutava em aceitar como "demonstrado" um resultado que nenhum ser humano conseguia verificar sozinho, passo a passo, da forma tradicional.
A objeção não era sobre o resultado estar errado, era sobre o que conta como prova quando uma parte essencial do raciocínio acontece dentro de uma máquina que ninguém consegue ler linha por linha. Até hoje não existe uma demonstração do teorema das quatro cores que dispense o computador, mesmo a versão simplificada de 1996, com apenas 633 configurações, ainda depende dele. Em 2005, Georges Gonthier formalizou a prova inteira dentro do Coq, um assistente de demonstração automática, fechando a lacuna de confiança da forma mais rigorosa possível, com uma verificação formal linha a linha, o mesmo papel que o Lean cumpriu, décadas depois, no caso do Navier-Stokes.
Eu conto esta história, entre outras, no Volume 0 – Raízes da Matemática, da minha coleção Matemática para o Século XXI.
Um precedente humano: Andrew Wiles e o Último Teorema de Fermat
Vale comparar esse episódio com o exemplo mais famoso da história recente de uma demonstração matemática de altíssimo nível, ainda que sem IA nenhuma envolvida, e cuja origem é bem mais antiga.
Em 1637, o matemático francês Pierre de Fermat anotou, à margem de um exemplar do livro Arithmetica, de Diofanto, que não existem números inteiros positivos x, y e z que satisfaçam a equação xⁿ + yⁿ = zⁿ para nenhum valor de n maior que 2, e acrescentou, em latim, uma frase que se tornou célebre:
"Cuius rei demonstrationem mirabilem sane detexi. Hanc marginis exiguitas non caperet."

Em tradução livre: "Descobri uma demonstração verdadeiramente maravilhosa disso, que esta margem é estreita demais para conter." O chamado Último Teorema de Fermat ficou sem solução aceita por mais de 350 anos, e a demonstração que Fermat alegou ter nunca foi encontrada, a maioria dos matemáticos hoje acredita que ele estava enganado ou tinha, no máximo, um argumento incompleto.
Andrew Wiles trabalhou sozinho e em segredo por cerca de sete anos até apresentar uma demonstração em 1993. Wiles certamente usou computadores para escrever o texto, fazer cálculos auxiliares e testar exemplos ao longo da pesquisa, mas a prova em si não dependeu de verificação computacional maciça nem de um assistente formal como o Lean. Foi uma demonstração matemática tradicional, apoiada em teoria dos números, formas modulares e curvas elípticas, escrita em linguagem matemática comum e validada pela leitura e análise de matemáticos especialistas. Quando a prova foi submetida à revisão por pares, os revisores, entre eles o matemático Nick Katz, encontraram uma lacuna real no argumento. Levou mais um ano de trabalho, agora com a colaboração de Richard Taylor, para corrigir o problema. A versão definitiva foi publicada em 1995.
Essa diferença ajuda a situar, numa mesma escala, os três tipos de prova que este artigo já cobriu:
Prova tradicional (Wiles)
Escrita em linguagem matemática comum, lida e verificada inteiramente por seres humanos.
Prova assistida por computador (Teorema das Quatro Cores)
Usa software para verificar partes específicas, geralmente uma checagem exaustiva de casos, mas a estratégia e boa parte da verificação continuam humanas.
Prova formal (Coq, Lean)
Cada passo lógico é traduzido para uma linguagem que o computador consegue checar rigorosamente, sem depender do julgamento de um revisor humano.
Fermat disse ter uma demonstração que a margem era estreita demais para conter, e quando Wiles finalmente provou o teorema, séculos depois, fez isso da forma mais clássica possível: produzindo um argumento humano compreensível, não uma verificação automática por computador.
Um epílogo inesperado, dias antes de Navier-Stokes
Existe hoje um movimento ativo para formalizar grandes teoremas em sistemas como o Lean, e no caso de Fermat esse movimento já não é mais hipotético. Em 4 de setembro de 2026, quatro dias antes do anúncio sobre Navier-Stokes, a Anthropic publicou que seu modelo Claude produziu a primeira formalização completa e verificável por máquina do Último Teorema de Fermat, cerca de 13 milhões de linhas de código em Lean 4 e aproximadamente 29.500 teoremas de apoio, feita em cerca de 11 dias usando um sistema multiagente.
Isso não é uma nova demonstração, é uma tradução do argumento já existente, numa versão "do século XXI" da prova que incorpora desenvolvimentos posteriores de Khare-Wintenberger e Kisin, não literalmente o texto original de Wiles e Taylor, para uma linguagem que o computador confere passo a passo. O trabalho se apoiou em anos de esforço prévio: o projeto de formalização de Fermat liderado por Kevin Buzzard, do Imperial College London, iniciado em 2024, além da biblioteca Mathlib e de uma ferramenta chamada Prove2Me, de pesquisadores da Universidade Columbia. O próprio Buzzard revisou o resultado final e confirmou que a prova está completa, sem nenhuma suposição além dos axiomas da matemática.
O contraste fecha um ciclo interessante. O teorema que Fermat disse não caber na margem, resolvido por um humano em 1995 e revisado por humanos, foi traduzido para uma verificação inteiramente mecânica por IA em 2026, na mesma semana em que outro sistema de IA tentava gerar, do zero, uma demonstração para um problema que a matemática humana ainda não tinha resolvido. Um episódio mostra a IA traduzindo um raciocínio humano já validado, o outro mostra a IA gerando um raciocínio novo que ainda precisa da validação humana. É essa diferença, entre traduzir e gerar, entre confirmar e propor, que vale ter em mente.
Cinco escalas, a mesma distinção
Colocando os casos lado a lado dá para ver o mesmo padrão se repetindo, em escalas completamente diferentes, ao longo de quase cinquenta anos:
Aritmética simples (Exemplos 1 e 2). Um LLM sem ferramentas prevê o próximo token com base em padrões memorizados, funciona bem para contas pequenas e falha silenciosamente em contas grandes.
Aritmética com ferramentas (Exemplo 3). O mesmo LLM, ao reconhecer a necessidade, delega o cálculo para um interpretador de código, trocando previsão por execução determinística e eliminando o erro.
Prova com computador auxiliar, conduzida por humanos (Teorema das Quatro Cores, 1976). Appel e Haken usaram o computador só para uma parte do trabalho, a checagem exaustiva de milhares de configurações, mas a estratégia e boa parte da verificação continuaram humanas. O resultado só foi considerado plenamente confiável quase trinta anos depois, com a formalização de Gonthier em Coq, em 2005.
Prova inteiramente humana, formalizada por IA décadas depois (Fermat, Wiles e Claude). Wiles gerou e a comunidade matemática validou a prova, inteiramente por meios humanos e tradicionais, entre 1993 e 1995. Em 2026, uma IA traduziu esse mesmo raciocínio para uma verificação mecânica completa, um trabalho de tradução e confirmação, não de descoberta.
Demonstração matemática de fronteira, gerada por IA (Navier-Stokes, 2026). Aqui não existe raciocínio humano prévio para traduzir, a IA gerou o argumento do zero, com milhares de agentes trabalhando em paralelo por menos de quatro dias. A verificação em Lean confirma consistência lógica interna, mas a validação que realmente decide se o resultado vale, a revisão pela comunidade matemática, ainda está em curso.
A lição que atravessa as cinco escalas é a mesma que abriu este artigo: um LLM prevê, ele não calcula, não prova nem formaliza por conta própria sem que humanos tenham, em algum momento, gerado o raciocínio original ou verificado o resultado gerado. O que muda, de um exemplo para o outro, é o quanto de trabalho humano, seja escrevendo o código de verificação, seja checando manualmente páginas de microficha, seja revisando uma demonstração linha por linha ao longo de décadas, ainda separa a resposta gerada da resposta em que se pode confiar.
Os fundamentos matemáticos por trás da mecânica de previsão de tokens, incluindo a camada de atenção e a função "softmax" que geram a distribuição de probabilidade discutida nos Exemplos 1 e 2, estão detalhados no Volume VI da coleção Matemática para o Século XXI, disponível aqui no site.
Comentários