
2 - Grafos e Machine Learning: a Álgebra Linear escondida em toda rede
Atualizado: 20 de ago.
O cenário
Imagine um modelo de Gradient Boosting treinado para prever preço de imóveis, usando três variáveis: "Area_construida", "Numero_quartos" e um "ID_do_corretor" (um identificador categórico com muitas categorias diferentes, um por corretor).
Três formas diferentes de medir importância, no mesmo modelo
Variável | Importância por impureza (Gini) | Importância por permutação | SHAP (média absoluta) |
Area_construida | 0,35 | 0,52 | 0,48 |
Numero_quartos | 0,15 | 0,18 | 0,22 |
ID_do_corretor | 0,50 | 0,08 | 0,05 |
Por que elas discordam tanto
A importância por impureza Gini (a que sai "de graça" do próprio algoritmo de árvore) tende a superestimar variáveis com muitas categorias distintas, como "ID_do_corretor", simplesmente porque uma variável com centenas de valores únicos oferece mais oportunidades de cortes na árvore, não porque ela é genuinamente mais preditiva. É por isso que ela aparece artificialmente inflada, 0,50, quase o dobro da segunda colocada.
A importância por permutação corrige parte desse viés: ela embaralha os valores de uma variável, mede o quanto a performance do modelo piora, e repete para cada variável. Aqui, "ID_do_corretor" desaba para 0,08, revelando que, apesar de aparecer muito na estrutura da árvore, ela contribui pouco para a capacidade preditiva real.
O SHAP (valores de Shapley), vai além, e mede a contribuição marginal de cada variável para cada previsão individual, depois agrega essas contribuições. Ele confirma a tendência da permutação (área é a mais importante, corretor é pouco relevante), mas com valores diferentes, porque a lógica matemática de cálculo é outra (baseada em teoria dos jogos), não em erro de previsão nem em estrutura de árvore.
A implicação prática é que se alguém apresentasse só a importância por impureza para justificar uma decisão de negócio ("o corretor é a variável mais importante para o preço"), estaria tirando uma conclusão equivocada, um artefato do algoritmo, não um sinal real dos dados. Isso é o tipo de armadilha que um framework de auditoria como o FAMP deveria capturar: não basta perguntar "o modelo tem uma medida de importância disponível", é preciso perguntar "qual medida, e ela é a mais adequada para a pergunta que está sendo respondida".
Qual é o nó mais importante numa rede?
Numa rede, é comum querer saber qual nó é o "mais importante". Mas essa pergunta, do jeito que foi feita, ainda não tem resposta matemática, porque "importante" pode significar coisas diferentes: pode ser o nó com mais conexões diretas, o nó mais próximo de todos os outros, o nó que serve de ponte entre partes da rede, ou o nó conectado a outros nós que também são importantes. Cada uma dessas ideias tem uma fórmula matemática própria, e essas quatro fórmulas juntas formam o que se chama de medidas de centralidade.

Acima, H e R têm o maior número de conexões diretas. M conecta os dois grupos. Qual você diria que é o nó mais importante, e por quê?
Como vimos, um grafo é formado por nós (as entidades) e links (as conexões entre elas), e pode ser representado por uma matriz de adjacência A, onde Aᵢⱼ vale 1 se existe link entre o nó i e o nó j, e 0 caso contrário. Vamos usar, ao longo deste artigo, a mesma rede pequena de exemplo: quatro pessoas, "Carla", "Ana", "Bruno" e "Diego", conectadas em sequência, Carla amiga de Ana, Ana amiga de Bruno, Bruno amigo de Diego.
Centralidade de grau: quem tem mais conexões
A medida mais simples é a centralidade de grau, o número de links que um nó tem, formalizada como
C_grau(i) = ∑ⱼ Aᵢⱼ
Na rede de exemplo, C_grau(Ana) = 2 e C_grau(Bruno) = 2, enquanto C_grau(Carla) = 1 e C_grau(Diego) = 1.

Essa medida responde "quantas conexões diretas esse nó tem", mas ignora completamente a posição do nó dentro da estrutura maior da rede. Dois nós podem ter o mesmo grau e ocupar papéis completamente diferentes, um deles pode ser essencial para conectar duas partes distantes da rede, o outro pode estar apenas numa ponta isolada, mesmo tendo o mesmo número de conexões.
Centralidade de proximidade: quem está mais perto de todo mundo
A centralidade de proximidade mede quão perto, em média, um nó está de todos os outros nós da rede, usando a distância mais curta (o menor número de links) entre pares de nós. Formalmente,
C_prox(i) = (n − 1) ÷ ∑ⱼ d(i,j)
onde d(i,j) é a distância mais curta entre os nós i e j, e n é o número total de nós da rede.
Calculando para a rede de exemplo (n = 4, então n − 1 = 3):
C_prox(Ana) = 3 ÷ [d(Ana,Carla) + d(Ana,Bruno) + d(Ana,Diego)] = 3 ÷ (1+1+2) = 0,75
C_prox(Bruno) = 3 ÷ [d(Bruno,Ana) + d(Bruno,Carla) + d(Bruno,Diego)] = 3 ÷ (1+2+1) = 0,75
C_prox(Carla) = 3 ÷ [d(Carla,Ana) + d(Carla,Bruno) + d(Carla,Diego)] = 3 ÷ (1+2+3) = 0,5
C_prox(Diego) = 3 ÷ [d(Diego,Bruno) + d(Diego,Ana) + d(Diego,Carla)] = 3 ÷ (1+2+3) = 0,5
Ana e Bruno, no centro da rede, têm proximidade maior (0,75) do que Carla e Diego, nas pontas (0,5). Isso já revela algo que o grau, sozinho, não mostrava com a mesma força: estar no meio da rede tem valor próprio, mesmo quando o número bruto de conexões é o mesmo.
Centralidade de intermediação: quem é a ponte
A centralidade de intermediação mede quantas vezes um nó aparece no caminho mais curto entre outros dois nós quaisquer da rede. Formalmente,
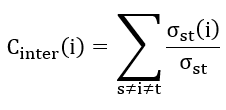
onde σₛₜ é o número total de caminhos mais curtos entre os nós s e t, e σₛₜ(i) é quantos desses caminhos passam pelo nó i.
Na rede de exemplo, vale a pena checar cada par de nós que não envolve o nó sendo medido:
Para Ana, os pares relevantes são (Carla, Bruno), (Carla, Diego) e (Bruno, Diego).
O caminho mais curto de Carla a Bruno passa por Ana (contribui 1).
O caminho mais curto de Carla a Diego também passa por Ana (contribui 1).
O caminho mais curto de Bruno a Diego é direto, não passa por Ana (contribui 0).
Logo,
C_inter(Ana) = 1 + 1 + 0 = 2
Por simetria, C_inter(Bruno) = 2 também (Bruno está no caminho entre Carla-Diego e entre Ana-Diego). Já Carla e Diego, por serem pontas da rede, nunca aparecem como intermediários de nenhum caminho entre outros dois nós, então:
C_inter(Carla) = C_inter(Diego) = 0
Essa medida é a mais estratégica das quatro: um nó com alta intermediação, mesmo com poucas conexões, controla o fluxo de informação entre partes da rede, removê-lo pode fragmentar a rede inteira em pedaços desconectados.
Centralidade de autovetor: quem está conectado a quem importa
A última medida, e a mais sofisticada, define a importância de um nó em função da importância dos seus vizinhos, não apenas da quantidade deles. Formalmente, o vetor de centralidades x satisfaz:

que, em notação matricial, é a equação de autovalor e autovetor Ax = λx, com λ sendo o autovalor dominante da matriz A. É o mesmo princípio matemático do PageRank, mencionado no artigo anterior desta série.
Detalhar aqui o cálculo de λ seria trabalhoso, mas a ideia central da centralidade de autovetor é que a importância de um nó depende da importância dos seus vizinhos, não só da quantidade de vizinhos.
Ana e Bruno não têm mais conexões do que qualquer outro nó nessa rede específica (todos têm grau 1 ou 2), mas cada um deles está ligado a outro nó que também tem um valor razoavelmente alto (Ana está ligada a Bruno, que por sua vez está ligado de volta a Ana, um reforço mútuo), enquanto Carla e Diego estão ligados só a um nó "do meio" (Ana ou Bruno), sem receber esse reforço de volta. É esse efeito de retroalimentação que a equação Ax = λx captura matematicamente.
Nesta rede pequena, podemos ver intuitivamente que Ana e Bruno se reforçam mutuamente, enquanto Carla e Diego, por estarem nas pontas, recebem apenas o "eco" de um vizinho central, sem devolver esse reforço, e o autovetor traduz exatamente essa intuição em números.
Comparando as quatro medidas
Nó | Grau | Proximidade | Intermediação | Autovetor |
Carla | 1 | 0,50 | 0 | 0,588 |
Ana | 2 | 0,75 | 2 | 0,951 |
Bruno | 2 | 0,75 | 2 | 0,951 |
Diego | 1 | 0,50 | 0 | 0,588 |
Nesta rede pequena e simétrica, as quatro medidas concordam sobre quem é mais importante, Ana e Bruno. Mas essa concordância não é garantida em redes maiores e mais irregulares: é perfeitamente possível um nó ter grau baixo e intermediação altíssima (um nó com poucas conexões, mas que é a única ponte entre duas partes grandes da rede), ou grau alto e autovetor baixo (um nó com muitas conexões, mas todas para nós pouco relevantes). Escolher a medida errada para o problema de negócio, uma delas otimizada para "quem tem mais contatos" quando a pergunta real é "quem controla o fluxo de informação", pode levar a uma decisão completamente equivocada.
Por que isso importa para quem trabalha com Machine Learning
Cada uma dessas quatro medidas pode virar, diretamente, uma variável de entrada para um modelo de Machine Learning. Um modelo de detecção de fraude pode se beneficiar mais da centralidade de intermediação (quem conecta diferentes clusters de contas suspeitas) do que do grau simples. Um modelo de recomendação pode se beneficiar mais da centralidade de autovetor (conectado a usuários que também são influentes) do que da proximidade. A escolha da medida certa não é um detalhe técnico secundário, é uma decisão que decorre diretamente do que a pergunta de negócio realmente está perguntando.
Continue essa jornada matemática
No próximo artigo desta série, "PageRank não é mágica: é um autovalor", vamos aprofundar a centralidade de autovetor que apareceu por último aqui, mostrando como o algoritmo que ordena páginas inteiras da web é, no fundo, a mesma matemática que acabamos de aplicar numa rede de quatro pessoas.
No Volume III, Redes, da coleção Matemática para o Século XXI, desenvolvo essas quatro medidas de centralidade com mais profundidade, incluindo redes maiores e menos simétricas, onde as quatro medidas deixam de concordar entre si, e a escolha da medida certa se torna uma decisão real de modelagem.

Comentários