
A Matemática das Árvores de Decisão: Como a Entropia de Shannon escolhe o melhor atributo?
Imagine que você precise identificar se um paciente está doente.
Você pode fazer dezenas de perguntas:

Mas qual pergunta deve ser feita primeiro?
Essa é a questão que uma árvore de decisão precisa responder.
Ao contrário do que muitos imaginam, ela não escolhe uma variável porque ela apresenta maior correlação com o resultado, nem porque possui maior coeficiente de regressão.
Ela escolhe a variável que mais reduz a incerteza.
E a matemática dessa incerteza foi desenvolvida por Claude Shannon, em 1948, muito antes da existência do aprendizado de máquina.
O problema matemático
Considere um conjunto de pacientes.

A probabilidade de um paciente estar doente é

A pergunta é: qual é o grau de incerteza existente antes de fazermos qualquer pergunta?
A ideia revolucionária de Shannon
Shannon mostrou que a informação está ligada à surpresa. Se um evento ocorre quase sempre, ele fornece pouca informação. Por exemplo, o Sol nascer amanhã, quase ninguém ficaria surpreso.Já um eclipse total inesperado produz enorme quantidade de informação.
Em outras palavras, quanto menor a probabilidade, maior a informação.
Matematicamente,
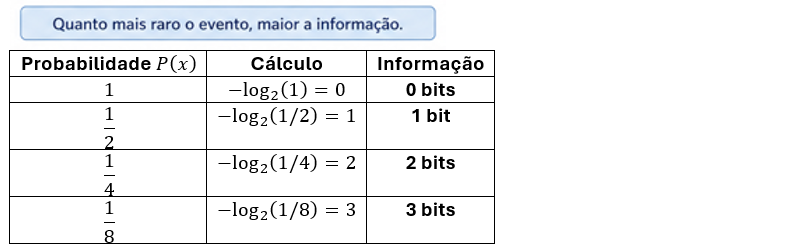
Esses números não foram escolhidos por acaso. Eles correspondem ao número mínimo de perguntas binárias ("sim/não") necessárias para identificar um evento quando todos os eventos são equiprováveis.
Por exemplo:
Se existem apenas 2 possibilidades (P=1/2), basta 1 pergunta.
Se existem 4 possibilidades (P=1/4), são necessárias 2 perguntas.
Se existem 8 possibilidades (P=1/8), são necessárias 3 perguntas.
É por isso que a unidade é chamada de bit: um bit corresponde à informação obtida com uma pergunta binária ideal.
Esse é justamente o elo entre a Teoria da Informação de Shannon e as árvores de decisão: cada divisão da árvore equivale, idealmente, a fazer uma pergunta que reduz ao máximo a incerteza sobre a classe da observação.
Da informação à entropia
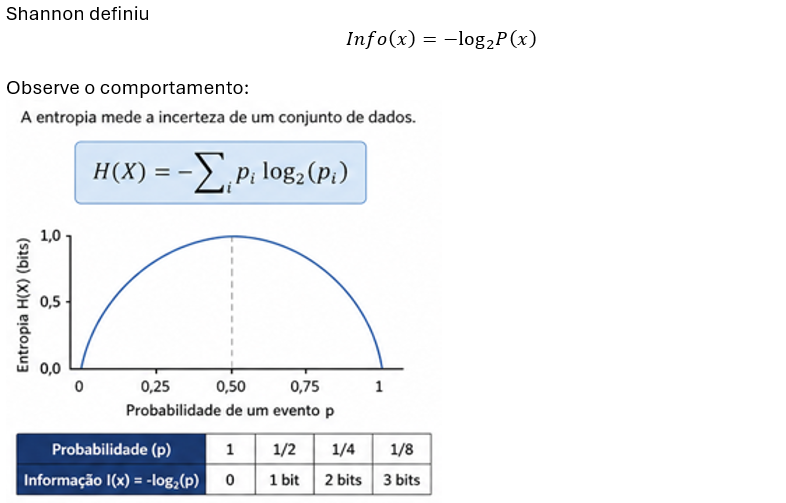
Uma base de dados possui vários resultados possíveis, portanto, o que interessa é a informação média. Shannon chamou essa quantidade de Entropia

Mas o que significa 0,918?
Bit, nesse contexto de teoria da informação, não é a mesma coisa que um bit de computador, que só pode valer 0 ou 1, um valor discreto e inteiro. Bit, na entropia de Shannon, é uma unidade de medida contínua, do mesmo jeito que metro é uma unidade contínua de distância. Você pode ter 1,5 metro, mesmo que nenhum objeto físico seja "meio metro" de forma discreta. Da mesma forma, você pode ter 0,918 bit de entropia, mesmo que nenhuma "unidade de informação" física seja fracionada.
A entropia mede o grau médio de incerteza.
Considere três situações.

Um médico, antes de perguntar qualquer coisa, ele sabe apenas que:
67% dos pacientes estão doentes;
33% não estão.
Esse conhecimento já reduz um pouco sua dúvida.
Por isso, a incerteza não vale 1. Vale 0,918
Um gráfico ajuda

Observe que:
a entropia é zero quando todos pertencem à mesma classe;
cresce à medida que as classes ficam mais equilibradas;
atinge o máximo em 50% × 50%;
depois diminui novamente por simetria.
Essa é a razão pela qual uma árvore de decisão busca uma divisão que reduza a entropia: ela procura transformar um conjunto "misturado" (alta incerteza) em subconjuntos cada vez mais homogêneos (baixa incerteza).
Na minha opinião, essa interpretação é muito mais importante do que a própria conta. Você precisa compreender que 0,918 não é apenas um resultado numérico; é uma medida quantitativa do quanto ainda estamos "confusos" sobre a classe das observações antes de fazer a primeira pergunta.
O objetivo da árvore
Agora imagine perguntar:
O paciente tem febre?
Suponha que todos os pacientes com febre estejam doentes.
Nesse grupo, a entropia passa a ser
H = 0
Não existe mais incerteza.
Já entre os pacientes sem febre, talvez ainda exista alguma mistura. A nova entropia será pequena. Portanto, essa pergunta reduziu bastante a incerteza.

Ganho de Informação
A árvore mede exatamente essa redução.
Define-se
IG = H(Pai) - H(Filhos)
Esse valor recebe o nome de Information Gain ou Ganho de Informação. Quanto maior, melhor.
Suponha que a entropia inicia =0,918.
Para as entropias ponderadas dos subgrupos após a divisão, o cálculo é idêntico ao que fizemos para a entropia inicial.
Após dividir pela variável "Febre", a média ponderada das entropias torna-se
0,31
Logo,
o ganho de informação é
IG = 0,918 - 0,31 = 0,608

Agora considere outra variável, como idade. Após essa divisão, suponha que a entropia cai apenas para 0,71.
O ganho será
IG = 0,918 - 0,71 = 0,208
A árvore escolhe automaticamente Febre, pois reduz muito mais a incerteza.

A árvore não está procurando correlação linear, como na regressão. Ela está procurando divisões que reduzam ao máximo a incerteza sobre a classe. É um objetivo matemático diferente, que não depende de coeficientes de correlação ou R².

Uma interpretação probabilística
Entropia mede o número médio de bits necessários para identificar corretamente uma observação. Quanto menor a entropia, menos perguntas serão necessárias.
Em outras palavras, a árvore procura fazer a pergunta mais inteligente possível.
E por que usar logaritmo?
O logaritmo possui duas propriedades fundamentais.
Primeiro, transforma probabilidades muito pequenas em valores grandes, o que representa corretamente a ideia de surpresa.
Segundo, permite que informações independentes sejam aditivas, propriedade essencial na Teoria da Informação.
Sem o logaritmo, a fórmula de Shannon simplesmente não funcionaria.
A ligação com a Inteligência Artificial moderna
A maioria das pessoas acredita que a Teoria da Informação pertence apenas às telecomunicações.
Na realidade,
ela aparece em praticamente toda a IA moderna.
Encontramos a entropia em
árvores de decisão;
Random Forest;
Gradient Boosting;
modelos bayesianos;
aprendizado por reforço;
compressão de dados;
modelos generativos;
grandes modelos de linguagem (LLMs).
Sempre que um algoritmo procura reduzir incerteza, há uma boa chance de que a matemática de Shannon esteja presente.
Conclusão
Quando uma árvore de decisão escolhe uma variável, ela não está "adivinhando" qual atributo parece melhor. Ela realiza um cálculo preciso da redução esperada da incerteza produzida por cada possível divisão dos dados.
A entropia de Shannon fornece exatamente essa medida. O ganho de informação compara a incerteza antes e depois da divisão e seleciona o atributo que mais organiza os dados. Assim, o algoritmo transforma uma ideia intuitiva — "qual pergunta devo fazer primeiro?" — em um problema rigorosamente matemático.
Esse é um dos aspectos mais fascinantes da Inteligência Artificial: por trás de algoritmos aparentemente simples estão conceitos profundos desenvolvidos décadas antes do surgimento da própria IA.
A teoria criada por Claude Shannon para estudar comunicação tornou-se um dos pilares matemáticos das árvores de decisão e continua presente em muitas das técnicas que impulsionam os sistemas inteligentes atuais.
Agora que você entende por que a entropia de Shannon é a métrica que guia a escolha do atributo, está pronto para o próximo passo. Nos próximos artigos, vamos ver como essa lógica de redução de incerteza é usada em algoritmos muito mais poderosos: Bagging, Random Forest, Gradient Boosting e XGBoost. A base que você construiu aqui é o alicerce de todos eles.

Comentários