
Gradient Descent:a matemática que faz redes neurais aprenderem (Parte 1/3)
Introdução Geral da Série
Toda vez que você treina um modelo de machine learning — uma regressão logística, uma floresta aleatória, ou uma rede neural com bilhões de parâmetros — há um algoritmo trabalhando nos bastidores, repetindo a mesma pergunta milhares de vezes: estou indo na direção certa?
Esse algoritmo é o gradient descent.
Ele é simples na ideia, poderoso na prática, e compreendê-lo matematicamente muda a forma como você pensa em otimização. Esta série de três artigos explica o gradient descent do zero: a intuição geométrica, a matemática das derivadas parciais, as variantes estocásticas, e o código Python completo.
Neste primeiro artigo, vamos construir a base: o problema da otimização, a diferença entre soluções analíticas e numéricas, a intuição por trás do algoritmo, e a matemática fundamental que o sustenta — desde a derivada até o gradiente como vetor de derivadas parciais. Ao final, você entenderá não apenas como o gradient descent funciona, mas por que ele funciona.
Imagine que você está perdido numa montanha à noite, com neblina espessa. Você quer chegar ao vale — o ponto mais baixo. Não consegue ver o caminho completo, mas consegue sentir o chão sob os pés e medir a inclinação local.
A estratégia natural é: a cada passo, sentir em qual direção o terreno desce mais acentuadamente e andar nessa direção. Repetir até não conseguir mais descer.
Essa estratégia é exatamente o gradient descent.
Neste artigo, vamos explorar essa analogia em profundidade. Começaremos entendendo por que precisamos minimizar funções em machine learning. Em seguida, veremos a diferença entre resolver um problema de forma exata (solução analítica) e aproximá-lo passo a passo (solução numérica) — e por que a segunda abordagem é a única viável para modelos modernos.
Depois, mergulharemos na matemática: o que é uma derivada, o que é um gradiente, e por que o negativo do gradiente aponta para a direção de maior descida. Por fim, apresentaremos a regra de atualização que está no coração de todos os algoritmos de otimização em deep learning.
Ao final deste artigo, você terá uma compreensão sólida da intuição e da matemática que movem o gradient descent.
1. Gradient Descent: A Intuição e a Matemática por Trás do Algoritmo que Move a IA
1. Por que minimizar?
Em machine learning, o modelo aprende ajustando seus parâmetros θ (pesos) para que as previsões se aproximem dos valores reais. Essa discrepância é medida por uma função de custo J(θ) — por exemplo, o Erro Quadrático Médio (MSE) na regressão.
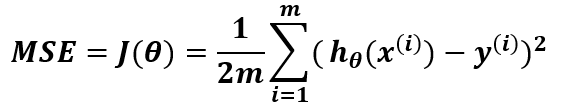
Onde:
é a previsão do modelo para o -ésimo exemplo de treino — ou seja, o valor que o modelo, com os parâmetros atuais, calcula ao receber a entrada . O "h" vem de hypothesis (hipótese), termo clássico da literatura de machine learning para "o que o modelo está apostando que a resposta é".
é o valor real e conhecido para esse mesmo -ésimo exemplo — o "gabarito", o que de fato aconteceu (por exemplo, o preço real de uma casa, se estivermos prevendo preços de imóveis).
é o número total de exemplos (ou observações) no conjunto de treinamento.
A diferença é o erro cometido pelo modelo naquele exemplo específico — previsão menos valor real. Elevamos ao quadrado para que erros positivos e negativos não se cancelem, e para penalizar mais os erros grandes.
Somamos esse erro ao quadrado para todos os exemplos, e dividimos por — a divisão por transforma a soma numa média (o erro típico por exemplo), e o fator extra de é só uma conveniência matemática que simplifica a derivada mais adiante (o do quadrado se cancela com o do denominador quando calculamos ).
Em uma frase: mede, em média, o quão longe as previsões do modelo estão dos valores reais — quanto menor esse número, melhor o modelo está performando.
Quanto menor J(θ), menor o erro e melhor o modelo.
Treinar um modelo é, portanto, um problema de otimização: encontrar os valores de θ que minimizam J(θ). Tudo o que o gradient descent faz é resolver esse problema.
Em álgebra, quando queremos minimizar uma função simples — como veremos em detalhe na Seção 4 — derivamos, igualamos a zero e resolvemos. Exato, instantâneo, elegante.
Mas uma rede neural com 175 bilhões de parâmetros (como o GPT-3) tem uma função de custo que vive num espaço de 175 bilhões de dimensões. Derivar e igualar a zero esse sistema de equações é computacionalmente inviável. Não existe forma fechada. A única saída é um método iterativo — dar passos sucessivos em direção ao mínimo, medindo a inclinação a cada passo.
2. Solução Analítica vs. Numérica
Solução analítica: resolver matematicamente, obtendo a resposta exata em um passo.

Solução numérica: aproximar a resposta por iterações sucessivas, refinando a cada passo.
Partimos de um chute inicial (por exemplo, x=5) e de uma taxa de aprendizado fixa (α=0,25). A cada passo, calculamos a inclinação e nos movemos na direção oposta:
x=3,25→2,38→1,94→1,72→1,61→⋯→1,5.
Repare como os passos ficam cada vez menores conforme nos aproximamos do mínimo — isso acontece porque a inclinação (a derivada) também diminui à medida que x se aproxima de 1,5.Chega no mesmo lugar, mas por tentativas.

Figura 1 - Rumo ao mínimo
A solução analítica encontra o mínimo exato em um único passo — quando existe. A solução numérica aproxima o mínimo por iterações sucessivas.
Em machine learning moderno, as funções de custo são não lineares e vivem em espaços de altíssima dimensão. O gradient descent é nossa ferramenta numérica universal.
3. A intuição: descendo uma montanha com neblina
Imagine que você está perdido numa montanha à noite, com neblina espessa. Você quer chegar ao vale — o ponto mais baixo. Não consegue ver o caminho completo, mas consegue sentir o chão sob os pés e medir a inclinação local.

A estratégia natural é: a cada passo, sentir em qual direção o terreno desce mais acentuadamente e andar nessa direção. Repetir até não conseguir mais descer.
Essa estratégia é exatamente o gradient descent. Na analogia:
Elemento da analogia | Correspondência matemática |
A montanha | A função de custo J(θ) — o erro do modelo |
Sua posição | Os parâmetros θ (pesos da rede neural) |
A inclinação local | O gradiente ∇J(θ) |
O tamanho do passo | A taxa de aprendizado α |
O vale | O mínimo da função de custo — o modelo bem treinado |
É por isso que o gradient descent é frequentemente descrito como um algoritmo de descida mais íngreme: a cada passo, ele se move na direção em que a função diminui mais rapidamente.
4. Derivadas: encontrando mínimos
Antes do gradiente, precisamos entender a ferramenta que o sustenta: a derivada.
A derivada de uma função num ponto mede a taxa de variação instantânea — ou seja, a inclinação da curva naquele ponto. Geometricamente, é o coeficiente angular da reta tangente.

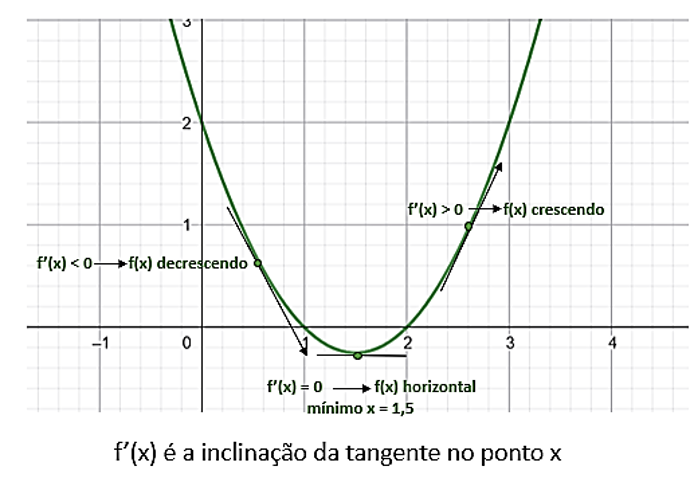
Figura 2 — Parábola f(x) = x²−3x+2 com retas tangentes nos três regimes:
(antes do mínimo), (no mínimo em x = 1,5) e (depois do mínimo).
Encontrando o mínimo analiticamente
Para encontrar o mínimo, igualamos a derivada a zero e resolvemos:

A concavidade para cima confirma que é um mínimo.
O gradient descent faz o mesmo caminho, mas de forma iterativa: em vez de resolver

ele segue o sinal da derivada passo a passo até chegar perto do zero.
Para regressão linear simples, a solução analítica existe e é eficiente. Mas uma rede neural com milhões de parâmetros gera um sistema de milhões de equações simultâneas — computacionalmente inviável. Além disso, funções de custo de redes profundas são não lineares: não têm solução analítica fechada.
O gradient descent é a única alternativa prática.
5. A matemática: gradiente e derivadas parciais
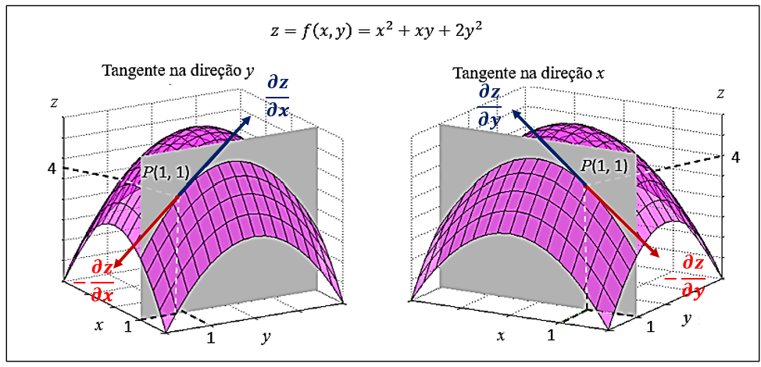
O gradiente é a extensão da derivada para funções de múltiplas variáveis. Em vez de uma inclinação escalar, temos um vetor de derivadas parciais — uma para cada parâmetro. Ele aponta na direção de maior crescimento da função. Para descer, caminhamos na direção oposta.

O gradiente (3, 5) diz que, naquele ponto, a função cresce mais rápido na direção de y (componente 5) do que na direção de x (componente 3). Para minimizar, andamos na direção oposta: (−3, −5).
Michel Janos
Autor de Matemática para o Século XXI — uma coleção de sete volumes cobrindo otimização, redes, sistemas dinâmicos, modelos baseados em agentes e machine learning com Python.

Comentários