
1 - Grafos e Machine Learning: Quando a estrutura dos dados é a informação
Atualizado: 20 de ago.
Toda vez que alguém desenha uma rede social, uma rede de transporte ou uma molécula como um conjunto de bolinhas conectadas por linhas, está fazendo mais do que uma ilustração. Está descrevendo um objeto matemático preciso, chamado grafo, e esse objeto pode ser representado inteiramente por uma matriz. Essa é a ideia central deste artigo: um grafo não é só um desenho, é uma matriz, e tudo que você já sabe sobre multiplicação de matrizes e autovalores se aplica diretamente a ele.
O que é um grafo, em termos simples
Um grafo é formado por dois elementos: nós (as entidades, por exemplo pessoas, cidades, páginas web) e links (as conexões entre esses nós, por exemplo amizades, rotas, hyperlinks). Um link pode ser não direcionado, quando a conexão vale nos dois sentidos (como uma amizade), ou direcionado, quando a conexão tem um sentido específico (como "segue" numa rede social, onde A pode seguir B sem que B siga A de volta).
Essa definição, por si só, já é suficiente para representar qualquer rede. A pergunta interessante é: como transformar esse desenho em algo que se possa calcular?
A matriz de adjacência
A resposta é a matriz de adjacência. Suponha uma rede com n nós. A matriz de adjacência, geralmente chamada A, é uma matriz n×n onde a entrada Aᵢⱼ vale 1 se existe um link entre o nó i e o nó j, e 0 caso contrário.
Um exemplo pequeno ajuda a fixar a ideia. Considere quatro pessoas, "Ana", "Bruno", "Carla" e "Diego", numa rede social simples, onde Ana é amiga de Bruno e de Carla, e Bruno é amigo de Diego.

A matriz de adjacência dessa rede é:

onde a linha e a coluna 1 representam Ana, a linha e coluna 2 representam Bruno, a linha e coluna 3 representam Carla, e a linha e coluna 4 representam Diego. Note que essa matriz é simétrica (Aᵢⱼ = Aⱼᵢ), porque a amizade, aqui, não tem direção. Se a rede fosse de "quem segue quem", a matriz normalmente não seria simétrica.
Até aqui, isso pode parecer só uma forma alternativa de guardar a mesma informação que o desenho já mostrava. A parte interessante começa quando se opera sobre essa matriz.
O grau de um nó, direto da matriz
Antes de multiplicar a matriz por ela mesma, vale fixar a quantidade mais simples que se pode extrair dela: o grau de um nó, o número de links que ele tem. O grau do nó i é a soma da linha i da matriz A:
grau(i) = ∑ⱼ Aᵢⱼ
No exemplo, o grau de Ana é a soma da primeira linha da matriz:
grau(Ana) = A(Ana,Bruno) + A(Ana,Carla) + A(Ana,Diego) = 1 + 1 + 0 = 2
O gráfico abaixo mostra o grau de cada um dos quatro nós dessa rede. Ana e Bruno, que têm duas conexões cada, aparecem com grau 2; Carla e Diego, que têm só uma conexão cada, aparecem com grau 1.

Isso pode parecer trivial, mas é a base de toda medida de centralidade que existe (grau, proximidade, intermediação, autovetor), cada uma parte de uma operação diferente sobre essa mesma matriz A, algo que será o tema do próximo artigo desta série.
Por que multiplicar a matriz por ela mesma responde uma pergunta real
Uma das propriedades mais úteis da matriz de adjacência é esta: se você calcular A² (a matriz A multiplicada por ela mesma), a entrada (A²)ᵢⱼ não é mais um valor binário de "existe ou não link direto", ela conta quantos caminhos (walk) de comprimento exatamente 2 existem entre o nó i e o nó j, passando por um único nó intermediário. Formalmente:
(A²)ᵢⱼ = ∑ₖ Aᵢₖ · Aₖⱼ
essa soma percorre todos os possíveis nós intermediários k, e cada termo só contribui com 1 se existir link de i até k e, ao mesmo tempo, link de k até j.
Abaixo a matriz A² completa, calculada entrada por entrada, para a rede Ana, Bruno, Carla, Diego (nessa ordem de linhas e colunas):
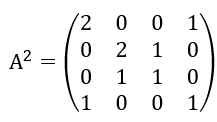
No exemplo acima, (A²)(Ana,Diego) conta quantos caminhos de comprimento 2 existem entre Ana e Diego. Aplicando a fórmula, testando os dois nós intermediários possíveis, Bruno e Carla:
(A²)(Ana,Diego) = A(Ana,Bruno) · A(Bruno,Diego) + A(Ana,Carla) · A(Carla,Diego)
= (1×1) + (1×0) = 1
Note as duas entradas que valem zero:
(A²)(Ana,Bruno) = 0 e (A²)(Bruno,Diego) = 0
Isso pode parecer estranho à primeira vista, já que Ana e Bruno são diretamente conectados, e Bruno e Diego também. Mas A² conta caminhos de exatamente 2 passos, não de 1 passo. Como Ana e Bruno já se conectam direto (em 1 passo), não existe nenhum caminho alternativo de 2 passos entre eles nessa rede pequena, por isso a entrada é 0. O mesmo raciocínio vale para Bruno e Diego.
(A²)(Bruno,Carla) = 1 revela que Bruno e Carla, que não têm link direto (a entrada A(Bruno,Carla) na matriz original é 0), têm exatamente um caminho de 2 passos entre eles: Bruno → Ana → Carla.
É o mesmo tipo de informação que "Ana e Diego têm um amigo em comum", só que aqui é "Bruno e Carla têm um amigo em comum", a saber, Ana.
Generalizando, (Aᵏ)ᵢⱼ conta quantos caminhos de comprimento exatamente k existem entre os nós i e j. Essa é uma pergunta genuinamente sobre a estrutura da rede ("quantos amigos em comum, de segundo, terceiro, quarto grau, dois nós têm entre si"), e a resposta vem de pura multiplicação de matrizes, a mesma operação que você já usa em qualquer outro contexto de álgebra linear.
Autovalores: por que aparecem em quase tudo que se faz com grafos
A conexão mais profunda entre grafos e álgebra linear vem dos autovalores e autovetores da matriz A. Um autovetor v da matriz A, associado a um autovalor λ, satisfaz a equação
Av = λv
a mesma definição que você já conhece de qualquer curso de álgebra linear.
O que muda, no contexto de grafos, é a interpretação. O autovalor de maior módulo (chamado autovalor dominante ou principal) e seu autovetor associado carregam informação sobre a estrutura global da rede, não sobre um nó isolado. É esse princípio, autovetor dominante de uma matriz relacionada à estrutura de uma rede, que sustenta o PageRank, que voltará a aparecer, de forma mais aprofundada, mais adiante nesta série.
Por que isso importa para quem trabalha com Machine Learning
Um cientista de dados que só conhece dados tabulares tende a tratar toda informação como uma matriz de observações por atributos. Uma rede pede uma matriz diferente, a matriz de adjacência A, mas as operações que se aplicam sobre ela (multiplicação, autovalores, autovetores) são exatamente as mesmas ferramentas de álgebra linear já usadas em regressão, em redução de dimensionalidade, ou em qualquer outro método estatístico. Entender essa ponte, que um grafo é uma matriz, e que as perguntas sobre a rede se traduzem em operações matriciais concretas, é o primeiro passo necessário antes de qualquer discussão sobre GNNs (Graph Neural Networks) ou embeddings de grafos, temas dos próximos artigos desta série.
Continue essa jornada matemática
No próximo artigo desta série, "Centralidade: qual matemática decide quem é importante numa rede", vamos ver como o grau que calculamos aqui,
grau(i) = ∑ⱼ Aᵢⱼ
é só a mais simples entre várias formas matemáticas de medir importância dentro de um grafo, cada uma revelando um aspecto diferente da estrutura da rede.
No Volume III, Redes, da coleção Matemática para o Século XXI, desenvolvo essa representação matricial com muito mais profundidade, junto com as medidas de centralidade, fluxos e processos de difusão que partem diretamente dela, cada conceito construído passo a passo, com exemplos numéricos completos como o que você acabou de ver aqui.

Comentários