
Atenção: A Matemática Por Trás do "Attention Is All You Need
Toda vez que um modelo de linguagem decide a que uma palavra se refere numa frase — "o gato que fugiu do quintal, ele estava com fome" — ele está resolvendo o mesmo problema matemático, bilhões de vezes por segundo: quais palavras anteriores merecem minha atenção agora?
Em agosto de 2017, pesquisadores do Google publicaram um artigo com um título direto: "Attention Is All You Need". A ideia central substituiu a recorrência (RNNs, LSTMs) por um mecanismo que processa a sequência inteira em paralelo, capturando contexto global de um jeito que os modelos anteriores não conseguiam. É essa arquitetura — o Transformer — que sustenta GPT, BERT, Claude, e praticamente todo LLM em uso hoje.
O problema: uma palavra sozinha não significa muita coisa
Considere: "Preciso ir ao banco para depositar meu salário" vs. "O idoso sentou-se no banco da praça". A palavra "banco" é idêntica nas duas frases — mas um embedding estático (como Word2Vec) atribuiria a ela o mesmo vetor nos dois casos, ignorando o contexto que desambigua o significado.
A atenção resolve isso permitindo que cada palavra "consulte" todas as outras da sequência, e ajuste sua própria representação com base em quais delas são relevantes.
Tecnicamente, o que estamos descrevendo é auto-atenção (self-attention) — cada token da sequência comparado com todos os outros tokens da mesma sequência, incluindo ele mesmo. "Atenção", em sentido mais amplo, também pode descrever um token comparado com tokens de uma sequência diferente (o caso da atenção cruzada entre encoder e decoder, tema de um próximo artigo).
Por simplicidade, vamos usar apenas "atenção" para nos referirmos à auto-atenção.
Antes das fórmulas: o que é um vetor e o que é uma matriz
Antes de prosseguir, vale destravar dois termos que vão aparecer o tempo todo.
Um vetor é, simplesmente, uma lista de números — a forma como o Transformer representa uma única palavra internamente (o que chamamos de embedding).
Uma matriz, no sentido mais simples possível, é apenas uma tabela de números — e uma das matrizes mais intuitivas de entender é aquela que mede o quanto cada palavra de uma frase se relaciona com cada outra palavra da mesma frase, chamada de heatmap (mapa de calor).
Considere "O cachorro perseguiu o gato através da rua" (8 palavras): a figura abaixo mostra essa relação como um mapa de calor — quanto mais dourado/claro, mais forte a relação entre o par de palavras.
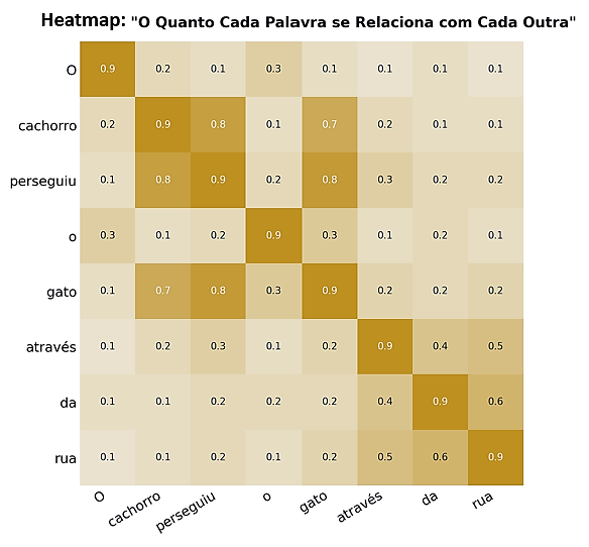
Repare no padrão: "cachorro" e "perseguiu" têm uma relação forte (0,8) — faz sentido, um é o sujeito, o outro é a ação. "Perseguiu" e "gato" também (0,7) — o verbo e seu objeto. Já "o" (artigo) tem relação fraca com quase tudo, exceto consigo mesmo — artigos carregam pouca informação sobre o significado da frase.
É exatamente esse tipo de matriz — uma tabela onde cada célula mede a relação entre um par de elementos — que vamos formalizar matematicamente ao longo do artigo. A diferença é que, no Transformer, essa "relação" não é definida à mão como no exemplo acima: ela é calculada automaticamente, a partir do vetor de cada palavra.
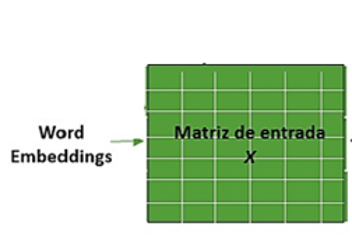
O heatmap acima — relacionando pares de elementos — é só uma prévia intuitiva do que vamos construir matematicamente. A matriz de verdade que o Transformer usa como ponto de partida, chamada X , é mais simples: é só a lista de embeddings de cada palavra, empilhados, sem nenhuma relação entre elas ainda — essa relação (parecida com o heatmap acima) é o que a atenção vai calcular.
A matemática: Query, Key, Value
Quando um Transformer recebe uma sequência de tokens, cada token é convertido num vetor de embedding x. A partir desse embedding, o modelo gera três vetores diferentes, através de matrizes de projeção aprendidas:
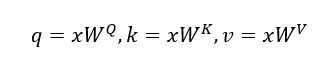
WQ, WKe WV, são três matrizes de números, de dimensão dmodel×dk ( figura abaixo), que começam com valores aleatórios antes do treinamento, e vão sendo ajustadas aos poucos, via backpropagation (o mesmo mecanismo do nosso artigo de Gradient Descent), até "aprenderem" a projetar cada embedding da forma mais útil possível para a tarefa do modelo.
Multiplicar o vetor x por uma dessas matrizes é o que gera cada um dos três vetores — q, k ou v — a partir da mesma entrada original. É por isso que essas três matrizes são chamadas de matrizes de projeção: cada uma "olha" para o mesmo embedding de um ângulo diferente, e o resultado dessa multiplicação é uma versão nova do vetor, sob essa perspectiva específica.
Cada uma dessas projeções cumpre um papel distinto — três "perguntas" diferentes feitas à mesma entrada. Se a frase tem L tokens, agrupamos os vetores individuais em matrizes, obtidas de forma compacta a partir da matriz de embeddings de entrada X :
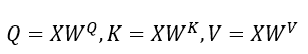
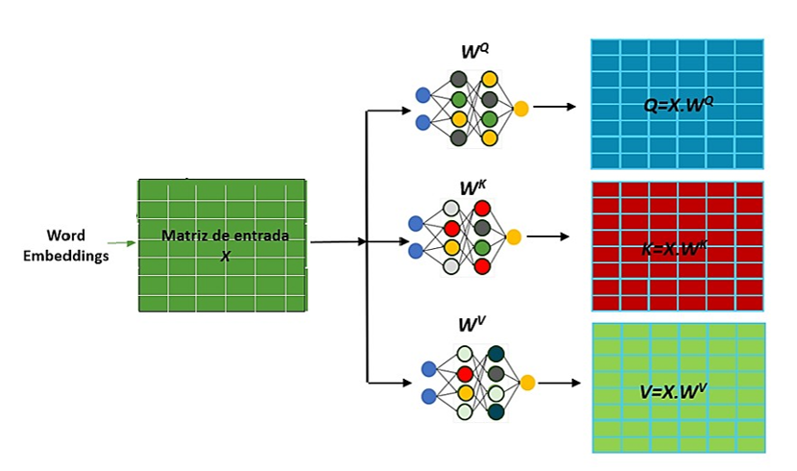
A analogia mais direta é com um mecanismo de busca de informação, como a pesquisa do Google (figura abaixo): a consulta (Q) é o termo que você digita na barra de pesquisa; as chaves (K) são os títulos/índices contra os quais sua busca é comparada; os valores (V) são o conteúdo de fato recuperado. O sistema compara sua consulta com as chaves no banco de dados, e pondera os valores com base na similaridade encontrada.
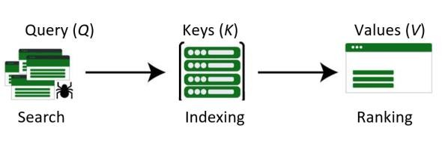
Por que isso é diferente de uma busca no Google
Quando você busca "banco" no Google, o mecanismo retorna uma lista de páginas ordenadas por relevância (usando um índice pré-calculado, como o próprio PageRank que já discutimos em outro artigo).
Mas repare: o Google não modifica a palavra "banco" — ele apenas retorna documentos externos, deixando a ambiguidade para você resolver (mostrando resultados mistos, ou priorizando um sentido se detectar contexto prévio na sua busca – figura abaixo).
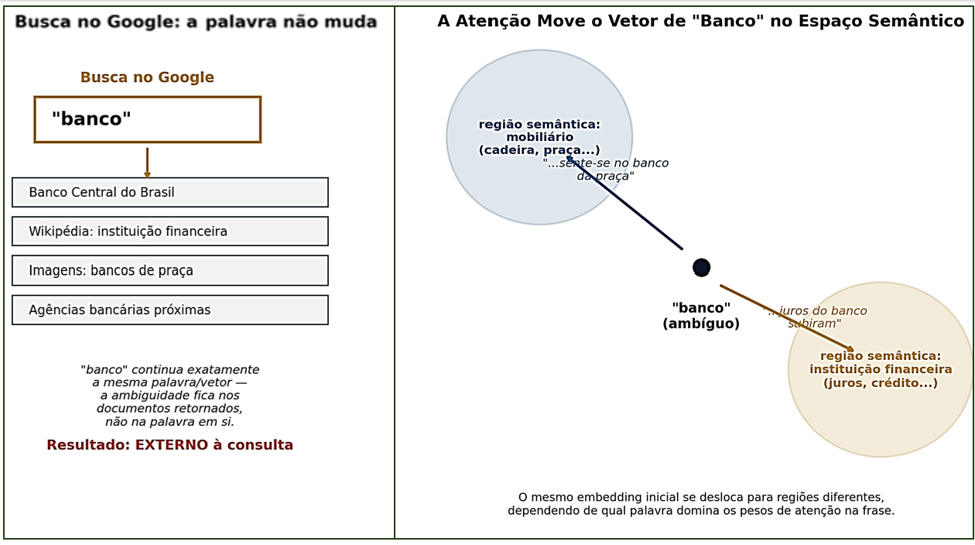
A atenção no Transformer resolve essa mesma ambiguidade de um jeito fundamentalmente diferente: internamente, ajustando o próprio vetor. Numa frase com "sente-se", o peso de atenção para essa palavra fica alto, e o embedding de "banco" se desloca para a região semântica de mobiliário. Numa frase com "juros", o peso de "juros" domina, e o mesmo embedding se desloca para instituição financeira. Não há "resultado externo" — o significado é recalculado dentro do próprio vetor, a cada passagem pela camada de atenção.
O score de atenção: comparando query com key
Para medir o quanto a palavra i deve prestar atenção à palavra j, calculamos o produto escalar entre o vetor query da palavra i e o vetor key da palavra j :
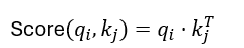
Esse produto escalar mede similaridade: se os dois vetores apontam em direções parecidas, o score é alto — a palavra i deveria prestar bastante atenção à palavra j.
Para tornar isso concreto, considere a frase "O cachorro perseguiu o gato através da rua", e suponha que o Transformer esteja processando o token "cachorro". Ele gera um vetor query para "cachorro", que será comparado com os vetores key de todas as outras palavras da frase. Palavras como "perseguiu" e "gato" tendem a ter escores altos — fazem parte do núcleo semântico da ação. Palavras funcionais como "o" ou "rua" tendem a ter escores baixos — carregam pouca informação sobre quem é "cachorro" naquele contexto.
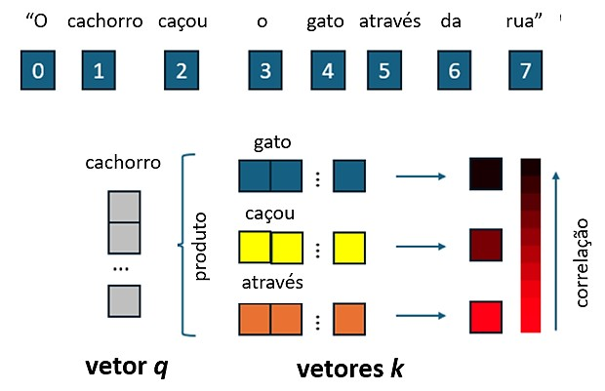
Esses escores se tornam os pesos de atenção, que determinam o quanto cada palavra contribui para a nova representação de "cachorro", agora sensível ao contexto.
Do Score à Matriz de Contexto: o Fluxo Completo
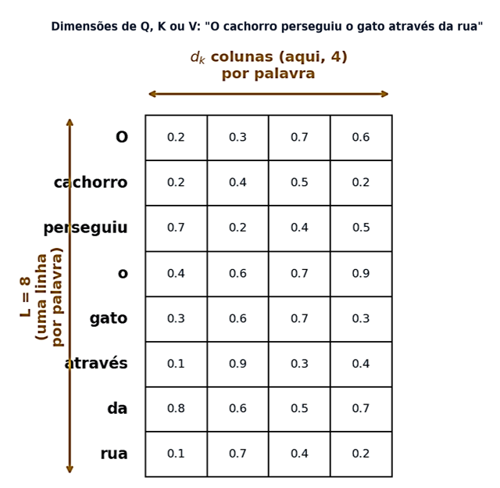
Como vimos acima, L é o número de tokens (palavras) da frase, e dk é o tamanho de cada vetor query/key — quantos números representam cada palavra nessa projeção específica, por exemplo é comum representar palavras com 512 números.
Assim, Q e K são matrizes de tamanho L x dk : uma linha para cada palavra dk , colunas de números por linha.
Agrupando o produto escalar de todos os pares de palavras numa única operação matricial, a matriz de atenção bruta é:

Como tem tamanho L x dk e KT(a transposta de K ) tem tamanho dk x L , o resultado tem tamanho L x L — uma pontuação de compatibilidade entre cada par de tokens da sequência.
Esse score passa por um escalonamento — dividir pela raiz quadrada de dk :
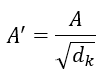
Esse ajuste existe por um motivo que conecta diretamente ao nosso artigo sobre Gradient Descent: sem ele, à medida que dk cresce, os produtos escalares tendem a crescer em magnitude, empurrando a próxima etapa (o softmax) para uma região onde sua derivada é praticamente zero — e um gradiente próximo de zero significa que a rede para de aprender naquele ponto.
O softmax é uma função que transforma qualquer lista de números numa distribuição de probabilidade: O softmax é aplicado linha a linha, cada valor vira um número entre 0 e 1, e a soma de toda a linha dá exatamente 1.
Aplicado a A’ ele converte os scores escalonados nos escores de atenção — a probabilidade de cada palavra "olhar" para cada outra:
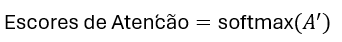
Voltando ao exemplo: depois do softmax, "cachorro" pode acabar distribuindo algo como 40% da sua atenção em "perseguiu", 35% em "gato", e o restante espalhado, de forma bem menor, entre as palavras funcionais.
Por fim, esses escores de atenção multiplicam (também de tamanho L x dk ), produzindo a matriz de contexto — a representação final de cada palavra, agora sensível a todo o resto da frase:
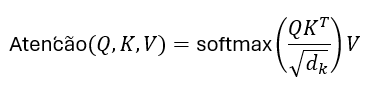
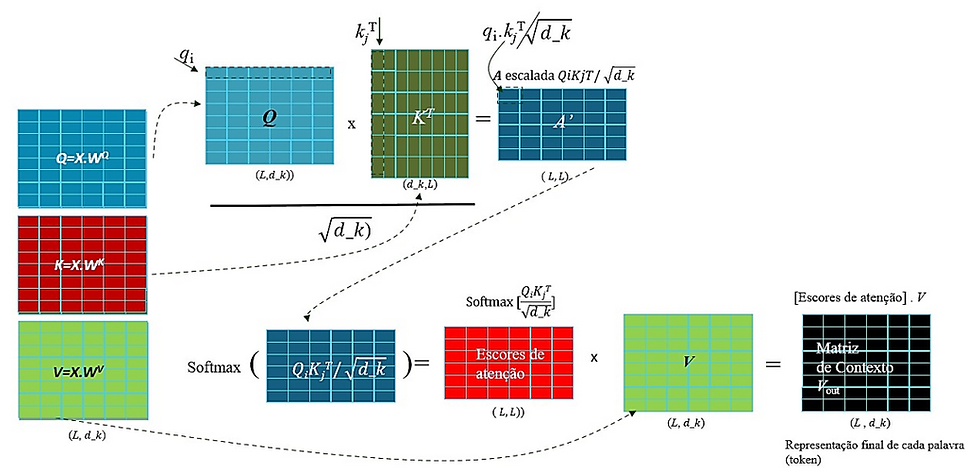
Repare, pelas dimensões marcadas na própria figura, que a matriz de contexto final tem exatamente a mesma fdimensão de V (L x dk ), que faz sentido: é uma média ponderada dos values, não uma estrutura nova.
Em palavras, o processo inteiro:
compare cada query com cada key (produto escalar), escalone para preservar o gradiente, normalize em probabilidade (softmax), e use essa probabilidade para fazer uma média ponderada dos values — produzindo um novo embedding para cada token, agora carregando informação de todo o contexto relevante ao seu redor.
Multi-Head Attention: várias perspectivas em paralelo
Uma única cabeça de atenção captura um tipo de relação. A divisão das dimensões do embedding em múltiplas cabeças de atenção é um aspecto fascinante dos Transformers, que contribui para seu notável desempenho.
Cada cabeça possui suas próprias matrizes WQ, WKe WV, Isso significa que cada cabeça enxerga a frase de um jeito diferente.
• Uma cabeça pode focar em relações sujeito–verbo.
• Outra pode focar em verbo–objeto.
• Outra pode capturar dependências longas.
• Outra pode observar artigos e preposições.
• Outra pode capturar semântica.
Todas essas perspectivas são combinadas dentro da mesma camada.
Antes de prosseguir, vale explicar o que é uma camada (layer). Uma camada é um bloco completo de processamento que recebe uma matriz de representações e devolve outra matriz do mesmo tamanho, só que mais refinada. O Transformer empilha várias dessas camadas, uma após a outra: a saída da camada 1 vira a entrada da camada 2, e assim sucessivamente, até a camada.
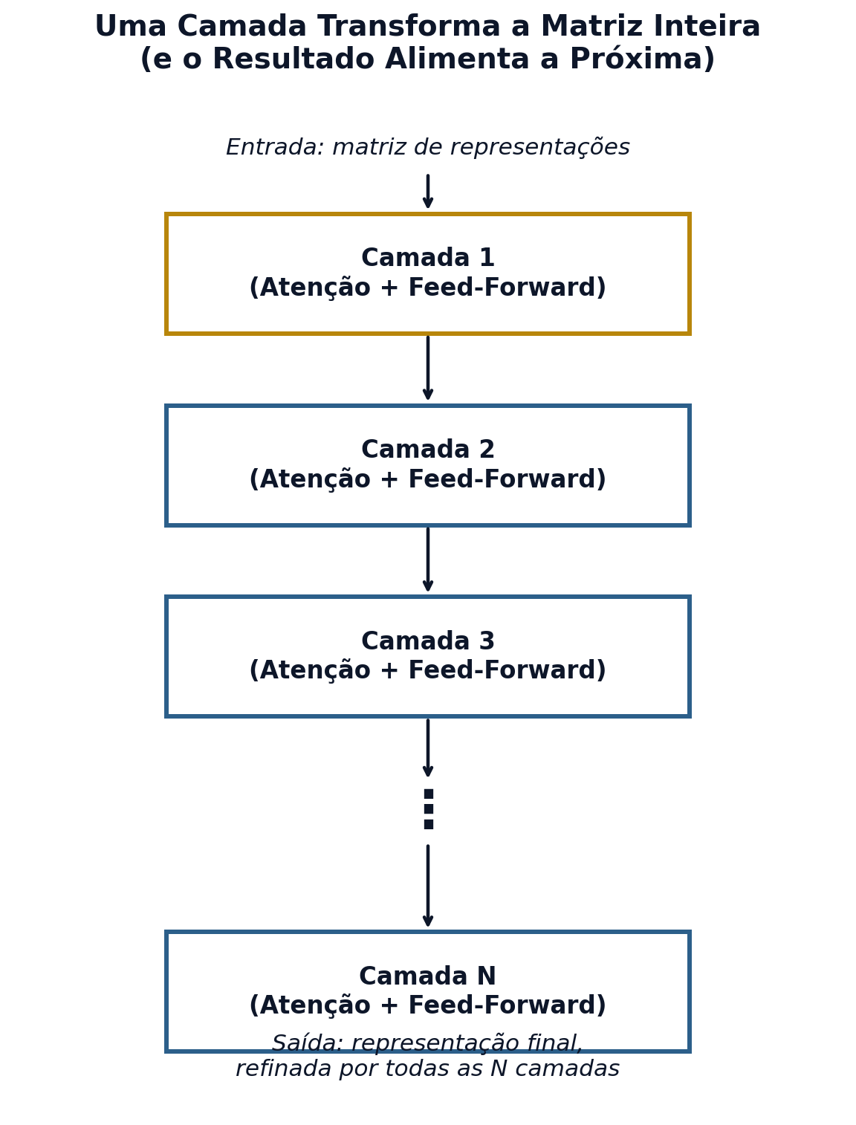
É por isso que o mesmo bloco (atenção + feed-forward, ver figura abaixo) se repete várias vezes, e cada repetição tem suas próprias matrizes de peso, aprendidas de forma independente. Isso significa que camadas diferentes podem, de fato, aprender a capturar aspectos diferentes da linguagem — a ideia que a analogia da escola, a seguir, ilustra.
Pense em uma escola:
As camadas são departamentos
Cada departamento tem uma especialidade:
Departamento (Camada) | Especialidade |
Camada 1 | Gramática e padrões locais |
Camada 2 | Sintaxe e estrutura |
Camada 3 | Semântica e significado |
As cabeças são os professores dentro do departamento.
Cada professor (cabeça) tem seu próprio método e foca em um tipo de relação:
• Professor de sujeito–verbo
• Professor de verbo–objeto
• Professor de dependências longas
• Professor de concordância
• Professor de preposições e artigos
Cada professor usa suas próprias ferramentas — os pesos WQ, WKe WV, — e faz perguntas diferentes aos alunos (tokens).
No final, o departamento combina o trabalho de todos os professores para produzir uma compreensão mais completa da frase.
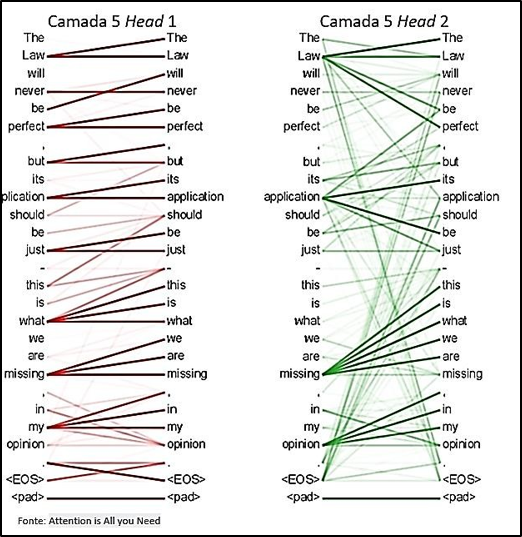
Matematicamente, cada cabeça tem suas próprias matrizes WhQ, WhKe WhV , e calcula sua própria saída:
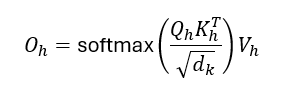
As saídas de todas as cabeças são concatenadas e projetadas de volta à dimensão original:
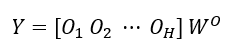
onde WO aprende a combinar as perspectivas de todas as cabeças numa única representação coerente — como um editor-chefe recebendo relatórios de vários repórteres e produzindo um texto final unificado.
Onde a Atenção entra no Transformer completo
O artigo de 2017 não descreve só o mecanismo de atenção isoladamente — ele o encaixa dentro de um bloco maior, repetido vezes tanto no Encoder quanto no Decoder. A figura abaixo mostra exatamente onde a peça que desenvolvemos aqui se encaixa:
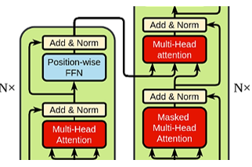
O Decoder tem uma estrutura semelhante, com uma camada extra de atenção cruzada (cross-attention) conectando-o ao Encoder. Encoder, Decoder, e os três tipos de arquitetura Transformer (encoder-decoder, somente-encoder como BERT, somente-decoder como GPT) serão o tema do próximo artigo desta série.
Onde isso se conecta na coleção
Volume I: produto escalar, multiplicação matricial e a função softmax são ferramentas de álgebra linear e probabilidade já desenvolvidas ali.
Nossa série de Gradient Descent: as matrizesWQ, WKe WV não são escolhidas à mão — são aprendidas via backpropagation, ajustadas a cada passo para minimizar o erro do modelo.
Nosso artigo sobre PageRank: a analogia da busca (Q, K, V como consulta/índice/conteúdo) se conecta diretamente ao mecanismo de ranqueamento que já exploramos — duas aplicações distintas da mesma ideia de "comparar e ponderar por relevância".
Volume VI: o capítulo completo desenvolve o exemplo de "O cachorro perseguiu o gato através da rua" por completo — a matriz de embeddings inteira, o cálculo de cada score, e a matriz de atenção completa, revelando exatamente quais palavras se tornam os "ímãs de atenção" da frase.
Para fechar
A atenção não é magia — é multiplicação de matrizes, um produto escalar como medida de similaridade, e uma normalização (softmax) transformando isso em probabilidade. O que a torna poderosa não é nenhuma peça isolada, mas o fato de que as matrizes de projeção WQ, WKe WVsão aprendidas: o modelo descobre sozinho, a partir de dados, quais relações entre palavras importam para a tarefa que ele está resolvendo — e, diferente de uma busca externa no Google, resolve a ambiguidade recalculando o próprio significado internamente, vetor por vetor.

Comentários